Despliega la Memoria para Agentes Hindsight en Docker: Guía Completa de Configuración
Despliega Hindsight con Docker Compose y pgvector, configura las misiones Retain, Observations y Reflect, ejecútalo sobre OpenCode Go, conecta agentes de codificación y protege todo con backups.

Actualizado Publicado 37 min de lectura
La mayoría de los agentes de IA lo olvidan todo en el momento en que termina una conversación. Les dices tus preferencias, corriges sus errores, les pasas contexto, y la siguiente sesión empieza desde cero. Hindsight arregla eso.
Hindsight es un sistema de memoria para agentes open source creado por Vectorize.io. No se limita a guardar el historial de conversación como un registro de chat glorificado. En su lugar, extrae hechos, construye modelos mentales y aprende de las interacciones con el tiempo. En el benchmark LongMemEval (la prueba estándar para memoria de agentes), supera a cualquier otra solución disponible actualmente.
La idea central: los agentes deberían mejorar cuanto más los usas, de la misma forma en que un asistente humano aprende tus preferencias durante semanas y meses.
Esta guía recorre el despliegue de Hindsight en Docker con un backend PostgreSQL bien montado, y luego cubre todo lo que configuré después de la instalación: las misiones Retain, Observations y Reflect que definen lo que recuerda, ejecutar el LLM sobre una suscripción de OpenCode Go, conectar agentes de codificación (yo uso Pi, OMP y Droid contra la mía) y hacer backup de todo el conjunto.
También preparé un vídeo tutorial completo del despliegue:
Qué hace Hindsight realmente
Hindsight organiza la memoria en tres categorías:
- Hechos del mundo - Cosas que son verdad (“El proyecto usa PostgreSQL 17”)
- Experiencias - Cosas que ocurrieron (“El último despliegue se rompió por un problema de migración”)
- Modelos mentales - Patrones formados al reflexionar sobre hechos y experiencias (“Este usuario prefiere mensajes de error detallados frente a resúmenes breves”)
Cuando añades información nueva mediante la operación retain, Hindsight la pasa por un LLM para extraer entidades, relaciones y datos temporales. Los almacena como una combinación de embeddings vectoriales, índices de palabras clave y estructuras de grafo.
Cuando buscas con recall, ejecuta cuatro estrategias de recuperación en paralelo:
- Búsqueda semántica (similitud vectorial)
- Coincidencia por palabra clave (BM25)
- Recorrido del grafo (enlaces de entidades y relaciones)
- Filtrado temporal (rangos de tiempo)
Los resultados se fusionan con reciprocal rank fusion y se reordenan por relevancia.
La tercera operación, reflect, va más allá. Reúne memorias relacionadas y genera nuevas observaciones. Piénsalo como el agente reflexionando sobre lo que sabe, en lugar de limitarse a recuperarlo.
Prerrequisitos
Necesitarás:
- Un VPS o servidor casero con Linux. Recomiendo Hetzner o Hostinger para alojamiento VPS
- Docker y Docker Compose instalados
- Una API key de LLM. OpenAI funciona de inmediato, o usa una suscripción de OpenCode Go como hago yo (cubierto más abajo)
- Al menos 2 GB de RAM disponibles (la imagen slim usa menos, la imagen completa necesita más)
Los precios de los VPS han subido en 2026 en todos los proveedores — si estás reconsiderando una máquina alquilada, mira qué ha cambiado y cuándo un mini PC gana.
DigitalOcean $100 gratis Hetzner €20 gratis Hostinger VPSVariantes de la imagen Docker
Hindsight publica dos variantes de imagen:
| Variante | Tag | Tamaño (AMD64) | Qué incluye |
|---|---|---|---|
| Full | latest |
~9 GB | Modelo de embeddings local (BGE), reranker local (MiniLM), todas las dependencias |
| Slim | latest-slim |
~500 MB | Sin modelos locales, requiere proveedores externos de embeddings y reranker |
La imagen completa funciona de inmediato pero ocupa bastante disco y RAM. La imagen slim delega embeddings y reranking a servicios externos, que es lo que usa esta guía, ya que la mayoría de la gente que despliega en un VPS quiere mantener bajo el uso de recursos.
Con la imagen slim necesitas:
- Un proveedor de embeddings (OpenAI, Cohere o una instancia TEI local)
- Un proveedor de reranker (el reranker algorítmico RRF funciona bien y es gratis, o usa un servicio externo)
Desplegar Hindsight con Docker Compose
Esta configuración usa dos contenedores: PostgreSQL con pgvector para la base de datos, y el propio Hindsight. La extensión pgvector habilita la búsqueda por similitud vectorial que impulsa el recall semántico.
Crear el directorio del proyecto
mkdir -p ~/docker-apps/hindsight
cd ~/docker-apps/hindsight
Crear el archivo de entorno
cat > .env << 'EOF'
# Hindsight Deployment
OPENAI_API_KEY=your-openai-api-key-here
DB_PASSWORD=choose-a-strong-password
HINDSIGHT_ACCESS_KEY=choose-an-access-key
EOF
Reemplaza los valores:
OPENAI_API_KEY- Tu API key de OpenAI (empieza porsk-)DB_PASSWORD- Una contraseña fuerte para el usuario de PostgreSQLHINDSIGHT_ACCESS_KEY- Una clave que usarás para autenticar llamadas a la API e iniciar sesión en la UI web
Crear el archivo Docker Compose
services:
  db:
    image: pgvector/pgvector:pg17
    container_name: hindsight-db
    restart: unless-stopped
    environment:
      POSTGRES_USER: hindsight
      POSTGRES_PASSWORD: ${DB_PASSWORD}
      POSTGRES_DB: hindsight
    volumes:
      - ./pgdata:/var/lib/postgresql/17/docker
    networks:
      - web

  hindsight:
    image: ghcr.io/vectorize-io/hindsight:latest-slim
    container_name: hindsight-app
    restart: unless-stopped
    ports:
      - "18888:8888"
      - "9999:9999"
    environment:
      # LLM
      - HINDSIGHT_API_LLM_PROVIDER=openai
      - HINDSIGHT_API_LLM_API_KEY=${OPENAI_API_KEY}
      - HINDSIGHT_API_LLM_MODEL=gpt-4o-mini
      # Embeddings
      - HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
      - HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=${OPENAI_API_KEY}
      # Reranker (algorithmic, no cost)
      - HINDSIGHT_API_RERANKER_PROVIDER=rrf
      # Database
      - HINDSIGHT_API_DATABASE_URL=postgresql://hindsight:${DB_PASSWORD}@db:5432/hindsight
      - HINDSIGHT_API_WORKER_ID=hindsight-prod
      # API Authentication (Bearer token required for all API calls)
      - HINDSIGHT_API_TENANT_EXTENSION=hindsight_api.extensions.builtin.tenant:ApiKeyTenantExtension
      - HINDSIGHT_API_TENANT_API_KEY=${HINDSIGHT_ACCESS_KEY}
      # Control Plane auth (login required for Web UI)
      - HINDSIGHT_CP_ACCESS_KEY=${HINDSIGHT_ACCESS_KEY}
      # Control Plane -> API auth
      - HINDSIGHT_CP_DATAPLANE_API_KEY=${HINDSIGHT_ACCESS_KEY}
    depends_on:
      - db
    networks:
      - web

networks:
  web:
    external: true
Qué hace cada ajuste
Configuración del LLM - Hindsight necesita un LLM para la extracción de hechos, la resolución de entidades y la generación de respuestas. El modelo gpt-4o-mini funciona bien y mantiene los costes bajos. Puedes cambiarlo por gpt-4o si necesitas mejor calidad de extracción, o usar un proveedor totalmente distinto (Anthropic, Gemini, Groq, Ollama).
Embeddings - Convierten el texto en representaciones vectoriales para la búsqueda semántica. El modelo de embeddings de OpenAI es la opción más fácil con la imagen slim.
Reranker - La opción rrf (Reciprocal Rank Fusion) usa un enfoque algorítmico que no cuesta nada. Fusiona los resultados de las cuatro estrategias de recuperación sin necesitar un modelo ML separado. Si quieres mejor precisión en el ranking, puedes apuntar esto a un servicio externo de cross-encoder.
Worker ID - Establécelo con un valor estable. Sin él, Docker asigna el hostname del contenedor como worker ID, que cambia en cada reinicio. Cualquier tarea en proceso cuando el contenedor se cae queda aparcada bajo el ID antiguo sin forma de que el nuevo contenedor la recoja.
Autenticación - Tres ajustes relacionados que usan la misma clave de acceso:
HINDSIGHT_API_TENANT_API_KEY- Requerida como Bearer token para todas las llamadas a la APIHINDSIGHT_CP_ACCESS_KEY- Contraseña de inicio de sesión para la UI webHINDSIGHT_CP_DATAPLANE_API_KEY- Cómo se autentica la UI web ante la API
Configuración de red
Este archivo compose asume que tienes una red Docker existente llamada web. Créala con docker network create web si aún no lo has hecho. Si lo ejecutas de forma independiente sin Traefik u otros reverse proxies, puedes eliminar la sección networks y la línea external: true.
Arrancar los servicios
docker compose up -dComprueba que ambos contenedores están en ejecución:
docker compose psDeberías ver hindsight-db y hindsight-app ambos en estado running.
Revisa los logs si algo no va bien:
docker compose logs hindsightVerificar el despliegue
La API debería estar disponible en http://your-server-ip:18888 y la UI web en http://your-server-ip:9999.
Prueba la API con un health check rápido:
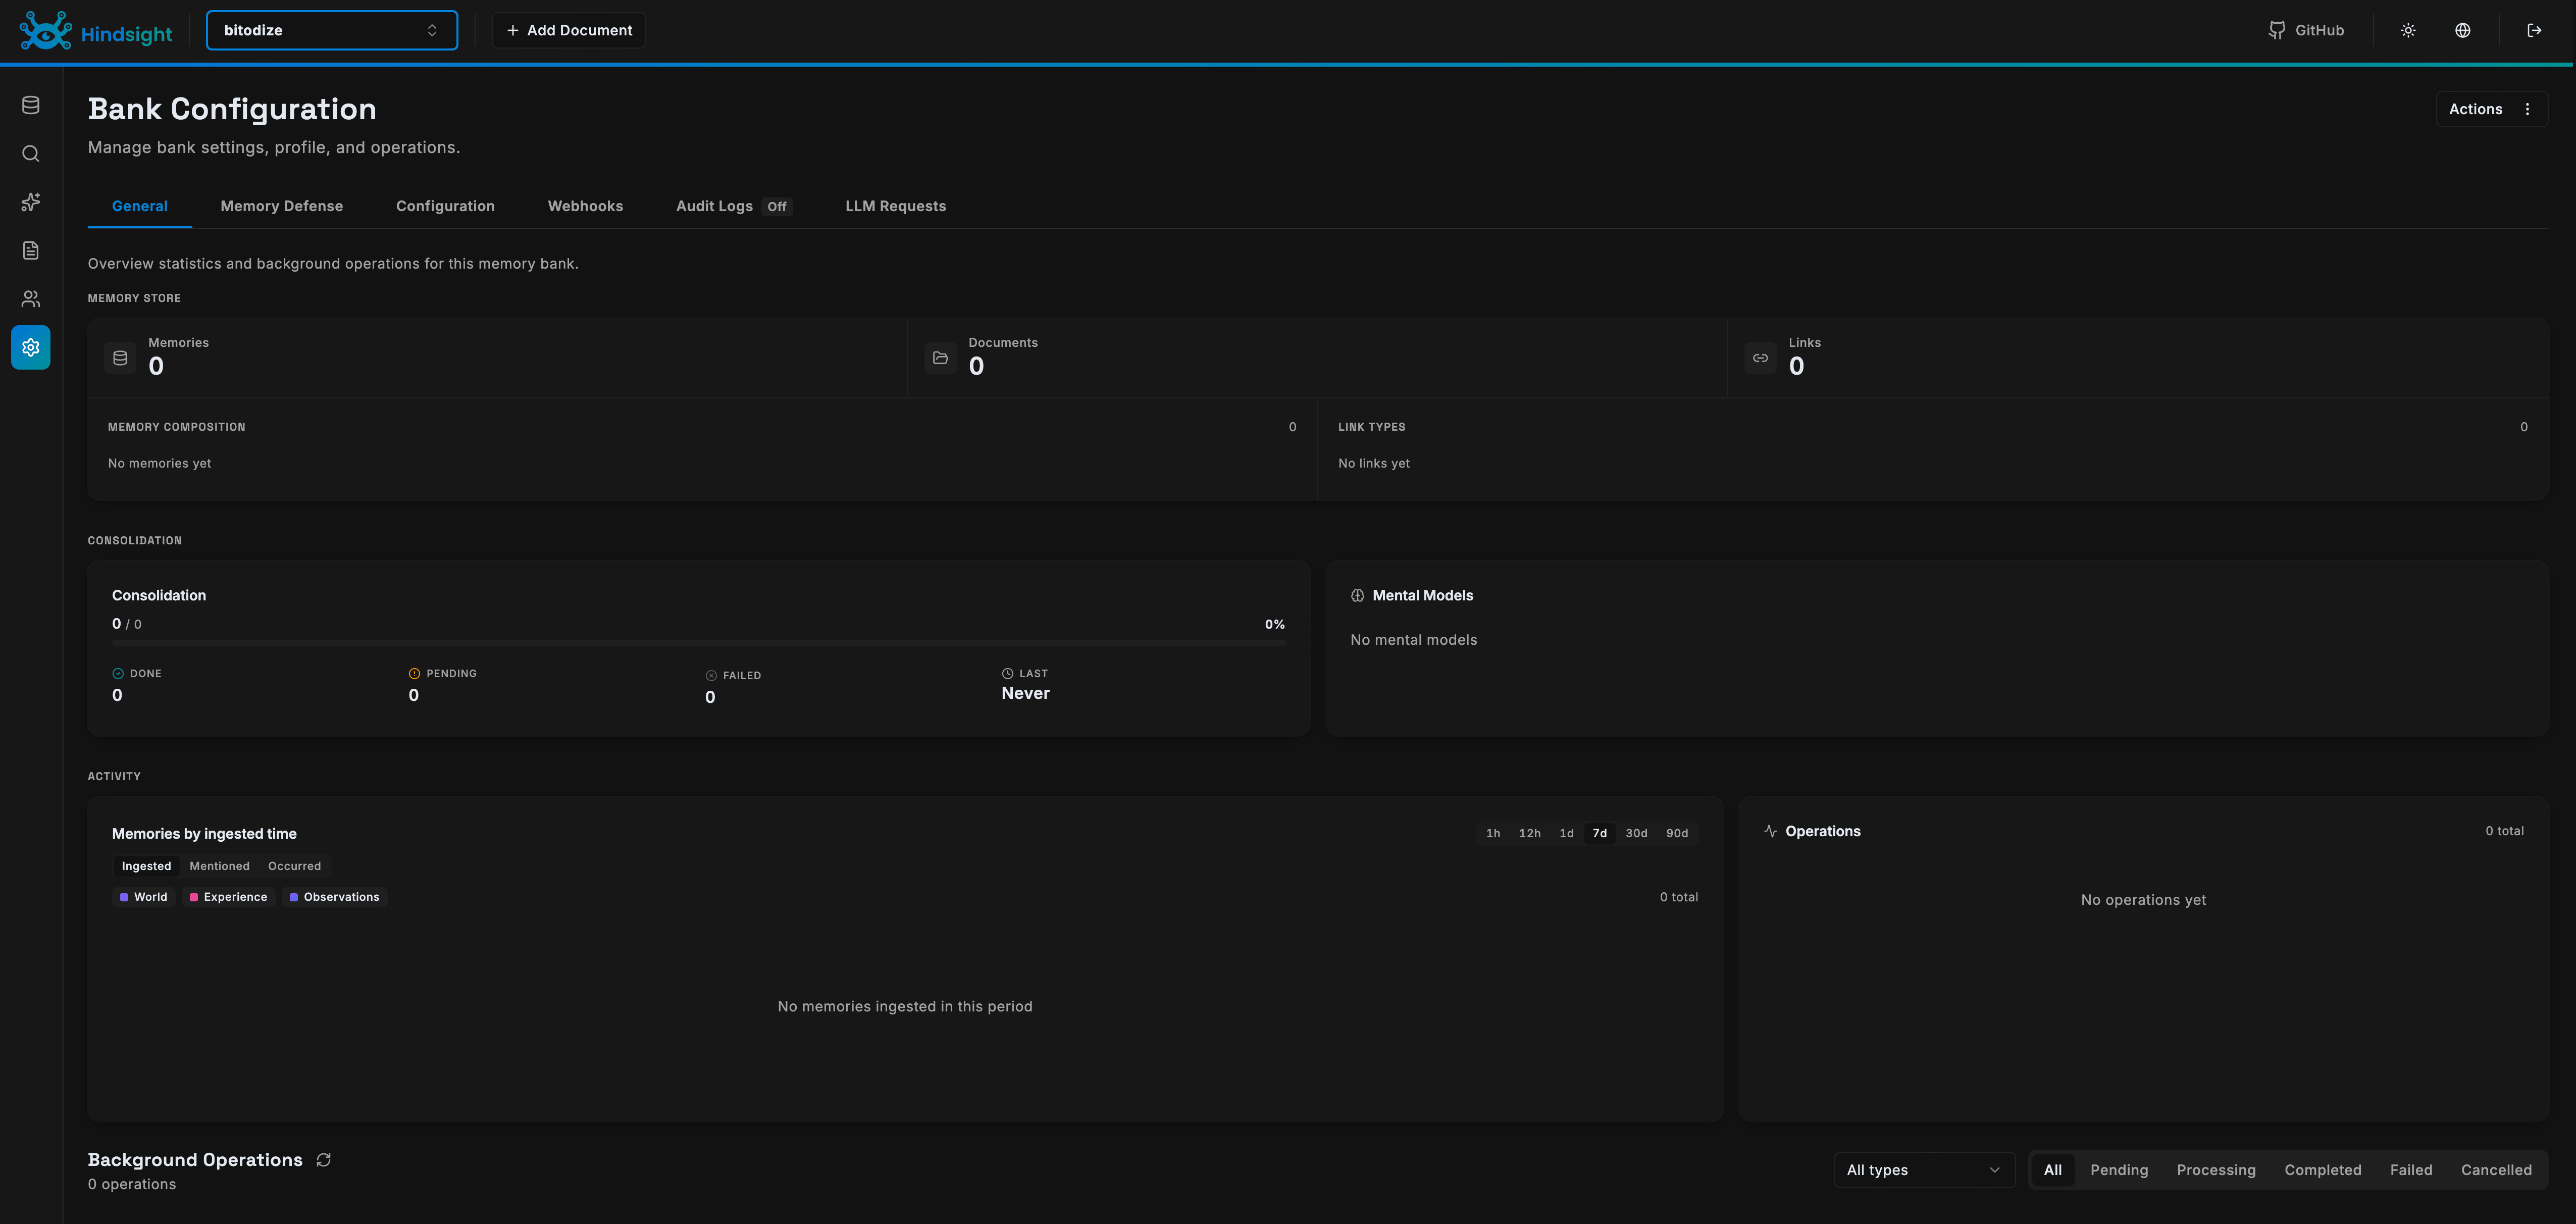
curl http://localhost:18888/v1/healthAbre la UI web en tu navegador e introduce tu clave de acceso cuando se te pida. El Control Plane te permite gestionar bancos de memoria, explorar entidades almacenadas y probar consultas sin escribir código.
Post-instalación: configura Retain, Observations y Reflect
Una instalación nueva de Hindsight funciona con los valores por defecto, pero los valores por defecto son genéricos. Tres ajustes lo convierten de un vertedero de hechos en algo que razona como tú quieres: la misión retain (qué se extrae), la misión observations (cómo se consolida el conocimiento) y la disposición y misión reflect (cómo responde). Todas son por banco de memoria, así que puedes afinar cada proyecto de forma distinta.
Puedes configurar todo desde la UI web (abre tu banco en el Control Plane y edita sus ajustes), pero usaré curl para que cada paso sea copiable y pegable. Cada petición necesita tu clave de acceso como Bearer token. Expórtala una vez:
export HINDSIGHT_URL=http://localhost:18888
export HINDSIGHT_KEY=your-access-key
Paso 1: Guarda una primera memoria
Los bancos se crean automáticamente en el primer retain, así que guarda un hecho para empezar:
curl -X POST $HINDSIGHT_URL/v1/default/banks/my-project/memories \
  -H "Authorization: Bearer $HINDSIGHT_KEY" \
  -H "Content-Type: application/json" \
  -d '{"items":[{"content":"Production runs PostgreSQL 17 on a Hetzner CX22"}]}'
La llamada responde inmediatamente. La extracción de hechos, la resolución de entidades y la generación de embeddings se ejecutan en segundo plano, por eso tu elección de LLM importa para la velocidad de ingesta.
Paso 2: Define la misión retain
Por defecto, retain extrae todos los hechos significativos de lo que le pases. La misión es una instrucción en lenguaje natural inyectada en el prompt de extracción que dirige lo que el LLM conserva. Es el ajuste de mayor valor de todo Hindsight: sin ella, los bancos se llenan de ruido; con ella, la extracción se centra en lo que realmente quieres recuperar después.
Este es el prompt que uso en mi banco personal:
Keep technical facts and decisions: commands that worked, configs, versions,
error messages together with their fixes, and URLs worth remembering.
Keep preferences about tools and workflows.
Ignore greetings, small talk, and throwaway debugging output that has no lasting value.
Aplícalo con un PATCH a la config del banco:
curl -X PATCH $HINDSIGHT_URL/v1/default/banks/my-project/config \
  -H "Authorization: Bearer $HINDSIGHT_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "updates": {
      "retain_mission": "Keep technical facts and decisions: commands that worked, configs, versions, error messages together with their fixes, and URLs worth remembering. Keep preferences about tools and workflows. Ignore greetings, small talk, and throwaway debugging output that has no lasting value.",
      "retain_extraction_mode": "concise"
    }
  }'
El modo de extracción controla cuánto se extiende el LLM:
| Modo | Cuándo usarlo |
|---|---|
concise (por defecto) |
Propósito general, selectivo, rápido |
verbose |
Hechos más ricos con contexto y relaciones completas |
custom |
Escribes tú mismo las reglas de extracción completas |
Si prefieres definirlo a nivel de servidor en vez de por banco, añade HINDSIGHT_API_RETAIN_MISSION al entorno del compose.
Paso 3: Define la misión observations
Después de cada retain, Hindsight consolida los hechos relacionados en observaciones: creencias desduplicadas respaldadas por evidencia, cada una registrando cuántas fuentes la apoyan. Las contradicciones no sobrescriben el historial. Si cambias de React a Vue, la observación acaba capturando el recorrido, no solo el destino.
La misión observations define qué forma deben tomar esas creencias. El comportamiento por defecto ya es bueno (hechos duraderos, preferencias, patrones recurrentes), pero puedes acotarlo:
curl -X PATCH $HINDSIGHT_URL/v1/default/banks/my-project/config \
  -H "Authorization: Bearer $HINDSIGHT_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "updates": {
      "observations_mission": "Observations are durable facts about my projects, infrastructure, and preferences. Always include recurring problems together with their fixes. Ignore ephemeral state such as running processes or current session details."
    }
  }'
La consolidación se ejecuta automáticamente tras cada retain. Si estás importando meses de historial y quieres hacerlo por lotes primero, pon HINDSIGHT_API_ENABLE_AUTO_CONSOLIDATION=false en el compose y actívala manualmente con una llamada a /v1/default/banks/my-project/consolidate cuando termine la importación.
Paso 4: Dale una personalidad a reflect
Recall recupera hechos. Reflect razona sobre ellos, y su estilo de razonamiento viene de tres rasgos de disposición más una misión. Los rasgos van en una escala de 1 a 5:
| Rasgo | Bajo (1) | Alto (5) |
|---|---|---|
| Escepticismo | Confía en la información tal cual | Cuestiona y duda de las afirmaciones |
| Literalismo | Lee entre líneas | Toma las cosas literalmente |
| Empatía | Distante, solo hechos | Pondera el contexto emocional |
Combinaciones recomendadas en la documentación: la revisión de código pide escepticismo 4, literalismo 5, empatía 2. El soporte al cliente pide escepticismo 2, literalismo 2, empatía 5. Un asistente de investigación se sitúa en el medio con 4/3/3.
Para mi banco de estilo DevOps, mantengo los rasgos en 3/3/3 y dejo que la misión haga el trabajo:
You are my DevOps and development assistant. You help manage Linux servers,
Docker services, and side projects. Prefer concrete commands over abstract
advice. Before recommending a risky change, state what breaks if it goes
wrong. Say so when the memories don't cover the answer.
Define la misión reflect y la disposición desde los ajustes del banco en la UI web, o a través del método update_bank_config() del SDK del cliente. Como las demás misiones, hay una variable de entorno (HINDSIGHT_API_REFLECT_MISSION) si la quieres a nivel de servidor.
Paso 5: Añade reglas duras con directivas
La disposición moldea el tono; las directivas son reglas que el agente debe seguir. Se inyectan en cada respuesta de reflect. Buenos candidatos: restricciones de cumplimiento, guardarraíles de privacidad, requisitos de salida.
curl -X POST $HINDSIGHT_URL/v1/default/banks/my-project/directives \
  -H "Authorization: Bearer $HINDSIGHT_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Safety first",
    "content": "Never suggest destructive commands (rm -rf, drop database, force push) without warning about backups first.",
    "priority": 10
  }'
Regla general de la documentación: la personalidad va en la disposición, el cumplimiento va en las directivas.
Paso 6: Afina el recall
Recall tiene dos controles que tocarás de verdad:
budget: profundidad de búsqueda.lowpara consultas a velocidad de chatbot,midpara consultas equilibradas,highcuando la pregunta necesita razonamiento multi-salto entre entidades (“¿en qué trabajaba el equipo del jefe de Alice?”).max_tokens: cuánto contenido de memoria vuelve, 4096 tokens por defecto (unas cuatro páginas). Bájalo a 2048 para respuestas enfocadas, súbelo a 8192 para preguntas de estilo investigación.
Ambos son parámetros por petición, no de configuración, así que pásalos en cada llamada según la consulta. También hay un filtro types si quieres solo observaciones, o solo hechos crudos del mundo.
Paso 7: Prueba el bucle completo
Dale un minuto tras el retain (la extracción y la consolidación necesitan tiempo), luego consulta:
# Recall: fast multi-strategy search
curl -X POST $HINDSIGHT_URL/v1/default/banks/my-project/memories/recall \
  -H "Authorization: Bearer $HINDSIGHT_KEY" \
  -H "Content-Type: application/json" \
  -d '{"query":"What database does production run?"}'

# Reflect: agentic reasoning over the bank
curl -X POST $HINDSIGHT_URL/v1/default/banks/my-project/reflect \
  -H "Authorization: Bearer $HINDSIGHT_KEY" \
  -H "Content-Type: application/json" \
  -d '{"query":"Summarize my production infrastructure"}'
Si recall no devuelve nada en el Paso 7, comprueba que la extracción terminó (mira la vista de operaciones en la UI web) y que tu clave de LLM funciona. Ese es también el momento en que te alegrarás de haber puesto un modelo barato para la extracción.
Modelos mentales y páginas de conocimiento
Dos funciones más que vale la pena conocer, ambas mejor añadidas tras unas semanas de uso real:
Los modelos mentales son respuestas permanentes a preguntas que haces a menudo. Defines la pregunta una vez, Hindsight escribe la respuesta y la reescribe en segundo plano a medida que el banco aprende. Obtener uno es una lectura de base de datos: sin recuperación, sin llamada al LLM, sin latencia. Créalos desde la UI web cuando notes que repites la misma pregunta.
Las páginas de conocimiento son el mismo motor disfrazado de wiki: documentos vivos organizados en carpetas (“Arquitectura”, “Runbooks”, “Decisiones”) que se reescriben a sí mismos a medida que cambia el conocimiento. El CLI puede montar un banco en disco como archivos markdown reales:
hindsight fs mount --bank my-bankDesde ahí, grep, fzf y cualquier editor funcionan con normalidad. Las páginas se curan a sí mismas: borra una y se reproyecta desde la memoria.
Ajustes de rendimiento para VPS pequeños
Hindsight hace el trabajo pesado de LLM durante las escrituras (extracción, consolidación) para que las lecturas sigan siendo rápidas: espera 100-600 ms para recall y menos de tres segundos para reflect. En un VPS pequeño, tres variables de entorno ayudan:
      # Don't saturate the LLM provider with parallel requests
      - HINDSIGHT_API_LLM_MAX_CONCURRENT=4
      # Skip reasoning-token overhead during extraction
      - HINDSIGHT_API_LLM_REASONING_EFFORT=low
      # Smaller consolidation batches = more reliable small-model responses
      - HINDSIGHT_API_CONSOLIDATION_LLM_BATCH_SIZE=4
Usar la API de Hindsight
Instalar el cliente
Python
pip install hindsight-clientNode.js
npm install @vectorize-io/hindsight-clientCLI
curl -fsSL https://hindsight.vectorize.io/get-cli | bashOperaciones básicas
Las tres operaciones trabajan sobre bancos de memoria. Un banco es un espacio de nombres para un conjunto de memorias relacionadas. Podrías tener un banco por usuario, por proyecto o por agente, según tu caso de uso.
Python
from hindsight_client import Hindsight

client = Hindsight(
    base_url="http://your-server:18888",
    api_key="your-access-key"
)

# Store a memory
client.retain(
    bank_id="my-project",
    content="The production database runs PostgreSQL 17 with pgvector"
)

# Search for memories
results = client.recall(
    bank_id="my-project",
    query="What database does production use?"
)

# Deep analysis of existing memories
insights = client.reflect(
    bank_id="my-project",
    query="What do I know about the production infrastructure?"
)
Node.js
import { HindsightClient } from '@vectorize-io/hindsight-client';

const client = new HindsightClient({
  baseUrl: 'http://your-server:18888',
  apiKey: 'your-access-key'
});

// Store a memory
await client.retain('my-project',
  'The production database runs PostgreSQL 17 with pgvector'
);

// Search for memories
const results = await client.recall('my-project',
  'What database does production use?'
);

// Deep analysis
const insights = await client.reflect('my-project',
  'What do I know about the production infrastructure?'
);
CLI
# Store a memory
hindsight memory retain my-project \
  "The production database runs PostgreSQL 17 with pgvector"

# Search for memories
hindsight memory recall my-project \
  "What database does production use?"

# Deep analysis
hindsight memory reflect my-project \
  "What do I know about the production infrastructure?"
Añadir contexto y marcas de tiempo
Puedes enriquecer las memorias con metadatos:
client.retain(
    bank_id="my-project",
    content="Migrated from SQLite to PostgreSQL after hitting performance issues",
    context="database migration",
    timestamp="2026-06-15T10:00:00Z"
)
Esto ayuda a Hindsight a organizar las memorias temporalmente y a entender el contexto en que se registró la información.
Usar el wrapper de LLM
La forma más rápida de añadir memoria a un agente existente es el wrapper de LLM. Se sitúa entre tu código y la API del LLM, almacenando y recuperando memorias automáticamente a medida que haces llamadas:
from hindsight import HindsightLLMWrapper
from openai import OpenAI

openai_client = OpenAI(api_key="your-openai-key")
wrapped_client = HindsightLLMWrapper(
    client=openai_client,
    hindsight_url="http://your-server:18888",
    hindsight_api_key="your-access-key",
    bank_id="my-agent"
)

# Use it exactly like the OpenAI client
# Memories are stored and retrieved automatically
response = wrapped_client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "What did we discuss yesterday?"}]
)
Opciones de proveedor de LLM
Hindsight soporta varios proveedores de LLM. La elección afecta tanto al coste como a la calidad:
| Proveedor | Modelos | Notas |
|---|---|---|
| OpenAI | gpt-4o-mini, gpt-4o | Buena opción por defecto. gpt-4o-mini es barato y funciona bien |
| Anthropic | Modelos Claude | Calidad de extracción fuerte |
| Gemini | Modelos Gemini | La propuesta de Google |
| Groq | Varios | Inferencia rápida, menor coste. Recomendado por Hindsight por velocidad |
| OpenCode Go | 16 modelos, una clave | Suscripción de tarifa plana, cubierta abajo |
| Ollama | Modelos locales | Autoalojado, sin costes de API, necesita más hardware |
| LM Studio | Modelos locales | Otra opción local |
Para cambiar de proveedor, modifica HINDSIGHT_API_LLM_PROVIDER y la variable de entorno de la API key correspondiente. Por ejemplo, para usar Groq:
environment:
  - HINDSIGHT_API_LLM_PROVIDER=groq
  - HINDSIGHT_API_LLM_API_KEY=${GROQ_API_KEY}
  - HINDSIGHT_API_LLM_MODEL=gpt-oss-20b
Usar OpenCode Go
Mi elección: OpenCode Go es una suscripción de $10/mes que agrupa 16 modelos detrás de una sola clave compatible con OpenAI. Grok 4.5, Kimi K3, DeepSeek V4 Pro, GLM-5.2, MiniMax M3, Qwen y más, sin facturación por token. Hindsight trae soporte nativo como proveedor:
Añade la clave a .env:
OPENCODE_GO_API_KEY=your-opencode-go-keyLuego cambia el bloque LLM en el archivo compose:
      # LLM - OpenCode Go
      - HINDSIGHT_API_LLM_PROVIDER=opencode-go
      - HINDSIGHT_API_LLM_API_KEY=${OPENCODE_GO_API_KEY}
      - HINDSIGHT_API_LLM_MODEL=deepseek-v4-flash
      # Embeddings stay on OpenAI (OpenCode Go covers chat models only)
      - HINDSIGHT_API_EMBEDDINGS_PROVIDER=openai
      - HINDSIGHT_API_EMBEDDINGS_OPENAI_API_KEY=${OPENAI_API_KEY}
Recrea con docker compose up -d y listo. Esta configuración exacta es la que ejecuta mi instancia de producción (actualmente tengo hy3 en el campo del modelo).
Por qué la tarifa plana importa aquí concretamente: la extracción de hechos y la consolidación son trabajos en segundo plano que consumen muchos tokens. Cada conversación que tus agentes de codificación retienen se procesa por este LLM las 24 horas, y con precios por token eso aparece como una sorpresa en la factura del mes siguiente. Con OpenCode Go la factura se queda en $10 sin importar cuánto movimiento de memoria haya.
Prueba OpenCode Go ($5 el primer mes)Una advertencia: solo cubre modelos de chat, así que los embeddings siguen necesitando su propio proveedor. Mantener la clave de OpenAI solo para embeddings cuesta céntimos a volúmenes típicos. Para un análisis más profundo de límites y benchmarks, mira mi reseña de OpenCode Go.
Exponer Hindsight de forma segura
Ejecutar Hindsight en el puerto 9999 está bien para acceso local. Si necesitas alcanzarlo desde internet, ponlo detrás de un reverse proxy.
Cloudflare Tunnel
La opción más fácil si ya usas Cloudflare. Añade el contenedor del tunnel a tu archivo compose y configúralo para enrutar el tráfico a los servicios de Hindsight. No hace falta exponer ningún puerto en el host.
Caddy
Lo que yo uso. Dos hostnames en el Caddyfile, certificados gestionados automáticamente:
hindsight.example.com {
    reverse_proxy localhost:9999
}

hindsight-api.example.com {
    reverse_proxy localhost:18888
}
El hostname de la API es al que apuntan tus agentes de codificación, incluyendo el endpoint MCP en /mcp/your-bank/.
Traefik
Añade labels al servicio hindsight en tu archivo compose para que Traefik los recoja. Necesitarás routers separados para la API (puerto 8888) y la UI web (puerto 9999).
Nginx
Monta una config de reverse proxy que reenvíe las peticiones a los puertos de Hindsight. Asegúrate de pasar la cabecera Authorization para las llamadas a la API.
Mantén la clave de acceso
Mantén siempre HINDSIGHT_API_TENANT_API_KEY configurada. Sin ella, cualquiera que pueda alcanzar el puerto de la API puede leer y escribir memorias. La clave de acceso protege tanto la API como la UI web.
Opciones de backup
Todo vive en PostgreSQL dentro de ./pgdata. Pierde ese directorio y cada hecho, observación y modelo mental desaparece. Tres formas de protegerlo, en orden creciente de esfuerzo.
Opción 1: pg_dump nocturno (empieza aquí)
Un dump lógico se mantiene consistente incluso con el contenedor en marcha, comprime bien y se restaura en cualquier instancia de PostgreSQL 17. Guárdalo como ~/scripts/hindsight-backup.sh:
#!/usr/bin/env bash
set -e
BACKUP_DIR=~/backups/hindsight
mkdir -p "$BACKUP_DIR"
docker exec hindsight-db pg_dump -U hindsight hindsight | gzip > "$BACKUP_DIR/hindsight-$(date +%F).sql.gz"
# keep two weeks
find "$BACKUP_DIR" -name "hindsight-*.sql.gz" -mtime +14 -delete
Hazlo ejecutable y prográmalo:
chmod +x ~/scripts/hindsight-backup.sh
crontab -e
# add:
15 4 * * * ~/scripts/hindsight-backup.sh >> ~/backups/hindsight/backup.log 2>&1
Restaurar en un contenedor de base de datos nuevo:
gunzip -c hindsight-2026-08-24.sql.gz | docker exec -i hindsight-db psql -U hindsight -d hindsightOpción 2: copias fuera del servidor
Un backup en el mismo VPS sobrevive a la mayoría de accidentes, no a todos. Empuja la carpeta de dumps a otro sitio con rclone (S3, Backblaze B2, cualquier remoto soportado):
rclone copy ~/backups/hindsight remote:hindsight-backups --max-age 48hAñade esa línea al script y tus dumps saldrán del servidor a las pocas horas de crearse. Si prefieres snapshots deduplicados en vez de archivos planos, restic funciona igual contra la misma carpeta.
Opción 3: herramientas de backup completas
Para backups automatizados y versionados a través de muchos contenedores uso Pluton (Restic + Rclone bajo el capó); Zerobyte cubre el mismo terreno. Apunta un plan a la carpeta de dumps, no al propio pgdata. Copiar los archivos de datos de PostgreSQL en caliente mientras la base corre produce snapshots que quizá no restauren limpiamente. Si aun así quieres backups a nivel de archivo de pgdata, para primero ambos contenedores (docker compose stop hindsight && docker compose stop db), haz el snapshot y vuelve a arrancarlos.
Un hábito que vale la pena robar de las bases de datos de producción: probar las restauraciones. Un backup que nunca has restaurado es una teoría. Una vez al trimestre, levanta un contenedor postgres desechable en tu portátil, carga el último dump y comprueba que recall sigue devolviendo respuestas sensatas.
Solución de problemas
El contenedor no arranca
Revisa los logs con docker compose logs hindsight. Problemas comunes:
- Fallo de conexión a la base de datos - Asegúrate de que el contenedor db está en marcha y sano. El contenedor de hindsight depende de él, pero a veces PostgreSQL tarda un momento en inicializarse.
- API key inválida - Verifica que tu clave de OpenAI es correcta y tiene créditos disponibles.
- Conflicto de puertos - Otra cosa está usando el puerto 18888 o 9999. Cambia el puerto del host en el archivo compose.
Las memorias no se recuperan
- Asegúrate de usar el mismo
bank_idpara las operaciones retain y recall. - Comprueba que el contenido que almacenaste es relevante para tu consulta. Hindsight usa búsqueda semántica, así que no hacen falta coincidencias exactas de palabras clave, pero el significado tiene que alinearse.
- Prueba la operación
reflectpara un análisis más profundo sirecalldevuelve resultados pobres.
Uso alto de memoria
La imagen completa carga modelos locales de embeddings y reranker que consumen 1.5-2 GB de RAM. Cambia a la imagen slim (la que usa esta guía) para bajar a unos 500 MB en el proceso de Hindsight. PostgreSQL usará lo que le des, pero 512 MB bastan para la mayoría de cargas de trabajo.
Conectar agentes de codificación
Aquí es donde Hindsight da sus frutos. Tus agentes ya producen la materia prima (conversaciones, decisiones, correcciones que funcionaron); las integraciones de abajo la canalizan a la memoria automáticamente e inyectan el contexto relevante al inicio de cada sesión. Tres formas de conectar un agente: el paquete oficial de integración, el soporte nativo en el propio agente, o el servidor MCP plano como respaldo.
El paquete oficial: Claude Code, Codex, opencode, Cursor CLI y compañía
Un paquete npm conecta doce agentes de forma nativa:
npx @vectorize-io/hindsight-coding-agents install claude-codeObjetivos soportados: claude-code, codex, opencode, cursor-cli, copilot-cli, kilo, cline-cli, prime-agent, dsh (DeepSeek Harness), agy (Antigravity), devin-cli, grok-build. O install all para cada agente que detecte en la máquina. Te pregunta dónde debe vivir la memoria; como tú te autoalojas, responde con flags:
npx @vectorize-io/hindsight-coding-agents install claude-code \
  --server self-hosted --api-url http://localhost:8888
(Si tu instancia está detrás de un reverse proxy, pasa su URL pública y añade tu clave de acceso vía apiToken en el archivo de configuración.)
Lo que obtienes es más que recall-al-prompt. La integración crea un banco por repositorio (coding-agent::{repo}) compartido por todos los agentes, siembra un repo frío desde el historial git, ejecuta una exploración de solo lectura del codebase limitada a $2 en tokens, mantiene las páginas de conocimiento al día y escribe las sesiones completadas de vuelta en la memoria. La configuración vive en un solo archivo, ~/.hindsight/coding-agent.json:
{
  "optInOnly": true,
  "optInPaths": ["~/work/client-x", "~/oss"],
  "gitIngest": "full"
}
Ese ejemplo convierte la memoria en opt-in solamente (nada fuera de las rutas listadas se recuerda) y activa la ingesta git de diffs completos. Actualizar es el mismo comando install otra vez; desinstalar elimina exactamente lo que se añadió.
Pi
Pi tiene un paquete de extensión dedicado:
pi install npm:@luxusai/pi-hindsightLuego abre Pi dentro de un repo y ejecuta /hindsight. Te pide tu URL de API (por defecto http://localhost:8888) y un perfil de memoria: Project + User, Project Only, User Only o Recall Only. Tras la configuración recupera la memoria relevante antes de cada llamada al modelo y retiene los deltas de sesión después de las ejecuciones completadas, redactando secretos comunes antes de escribir nada.
OMP (Oh My Pi)
OMP trae soporte para Hindsight de forma nativa, sin plugin. Edita ~/.omp/agent/config.yml:
memory:
  backend: hindsight

hindsight:
  apiUrl: https://hindsight.example.com/
  apiToken: your-access-key
  bankId: my-bank
Apunta apiUrl a tu instancia (local o detrás de un proxy), pon bankId donde quieras que aterricen las memorias de OMP, y reinicia. Su función autolearn va sobre el mismo backend.
Droid (Factory)
Droid se conecta a través del servidor MCP de Hindsight. Edita ~/.factory/mcp.json:
{
  "mcpServers": {
    "hindsight": {
      "type": "http",
      "url": "http://localhost:8888/mcp/my-bank/",
      "headers": {
        "Authorization": "Bearer YOUR_ACCESS_KEY"
      }
    }
  }
}
El nombre del banco en la ruta de la URL selecciona el modo de banco único, así que todo lo que hace Droid aterriza en un solo sitio. Para una instancia remota, sustituye tu URL pública; la cabecera Bearer funciona igual.
Cualquier otro: el servidor MCP como respaldo
Cualquier cliente compatible con MCP puede conectarse directamente:
# Connect Claude Code
claude mcp add --transport http hindsight http://localhost:8888/mcp/

# Or use single-bank mode for a specific memory bank
claude mcp add --transport http hindsight http://localhost:8888/mcp/my-bank/
El servidor MCP expone 29 herramientas incluyendo retain, recall, reflect, gestión de modelos mentales, creación de directivas y exploración de memoria. Mira la lista completa de integraciones para todos los clientes soportados.
¿Qué integración deberías usar?
| Situación | Elección |
|---|---|
| Tu agente diario es Claude Code, Codex, opencode o Cursor CLI | Paquete oficial, deja que gestione los bancos por repo |
| Quieres un cerebro compartido entre varios agentes distintos | Config nativa o MCP apuntando todos los agentes a un banco |
| Repos de cliente o empresa donde mezclar memorias estaría mal | Paquete oficial con optInOnly / overrides por banco |
| Agente que no está en ninguna lista de arriba | Servidor MCP |
Mi configuración real: OMP, Droid y Pi hablan todos con la misma instancia autoalojada. OMP y Droid comparten el único banco bitdoze porque quiero recall entre proyectos (“¿qué decidí sobre DNS el mes pasado?”). Pi mantiene bancos separados por proyecto mediante sus perfiles para trabajo de cliente donde las memorias no deben mezclarse. Si solo usas un agente, usa el paquete oficial y no pienses en bancos; si usas varios como yo, decide pronto si memoria compartida o separada encaja mejor con tu forma de trabajar, porque migrar bancos después es trabajo manual.
Asistentes de IA y frameworks
OpenClaw - Hindsight se integra con OpenClaw para añadir capacidades de memoria a flujos de trabajo de agentes basados en Claude. La infraestructura de memoria en producción incluye control de acceso en el servidor y un plugin con embeddings autogestionados.
Hermes Agent - Hindsight sirve como backend de memoria para el framework de mensajería multi-agente Hermes. Si ejecutas Hermes, esto reemplaza el MEMORY.md incorporado y la búsqueda de sesiones por un sistema basado en vectores más capaz.
Agno - Hay una integración directa para agentes Agno. En lugar de historial de chat respaldado por SQLite, obtienes memoria estructurada a largo plazo con extracción de entidades y búsqueda semántica.
Zed - El asistente de IA del editor Zed obtiene memoria a largo plazo a través del servidor MCP de Hindsight. Añádelo como una entrada de transporte HTTP en la configuración MCP de Zed.
Obsidian - A través del servidor MCP, puedes conectar los plugins de IA de Obsidian a Hindsight para memoria persistente en tus notas y flujos de investigación.
n8n - Un nodo de la comunidad para flujos de trabajo de n8n añade operaciones retain, recall y reflect. Suéltalo en cualquier workflow junto a Slack, Sheets, OpenAI y más de 400 integraciones.
Qué sigue
Una vez que Hindsight esté en marcha, aquí hay cosas que probar:
- Define las tres misiones de la sección de post-instalación de arriba; es la diferencia entre un vertedero de hechos y un cerebro
- Conecta tu agente de codificación usando el paquete oficial o las configuraciones de Pi/OMP/Droid cubiertas antes
- Crea bancos de memoria separados para diferentes proyectos o usuarios para mantener las memorias organizadas
- Añade modelos mentales para las preguntas que haces cada semana, y deja que las páginas de conocimiento crezcan hasta ser una wiki que se automantiene
- Programa el pg_dump nocturno antes de que se te olvide (mira las opciones de backup arriba)
- Compáralo con Cognee si también necesitas extracción de conocimiento de documentos y datos multimodales
Hindsight es una de esas herramientas que se vuelve más valiosa cuanto más tiempo la ejecutas. Los primeros días de memorias son útiles. A los pocos meses, el agente empieza a hacer conexiones que tú no le dijiste explícitamente. Son los modelos mentales entrando en acción, y ahí es donde aparece el valor real.