Uptime Kuma vs Gatus (2026): ¿Cuál Deberías Autoalojar?
Uptime Kuma vs Gatus comparados en un VPS real: instalación con Docker Compose, funciones de monitorización, alertas, páginas de estado y qué herramienta autoalojada elegir.

34 min de lectura
Si tu VPS ejecuta algo por lo que valga la pena despertarse, necesitas monitorización de uptime autoalojada que te avise antes de que lo hagan tus usuarios. La pregunta uptime kuma vs gatus es la primera bifurcación de ese camino. Ambos son sondeadores de caja negra gratuitos, de código abierto y de un solo contenedor, y ambos te avisarán a las 2 a.m. cuando el blog o la API caigan. Esta comparación usa las versiones de la era 2026: Uptime Kuma 2.5.3 (agosto de 2026) y Gatus v5.37.0 (septiembre de 2026), verificadas contra los proyectos originales el 27 de septiembre de 2026.
La diferencia en una frase: Uptime Kuma es un monitor de clics con una página de estado preciosa. Gatus es monitorización definida en YAML para quienes mantienen la infraestructura en git. Todo lo demás se deduce de eso.
Si llegaste buscando una alternativa a Uptime Kuma tras ver un archivo SQLite comerse un disco, o tras un hilo de «gatus vs uptime kuma reddit» que terminó en «los dos están bien, elige uno», esta es la versión para operadores. Ambas herramientas instaladas con Docker Compose en un VPS pequeño, los mismos cinco monitores configurados en cada una, los modos de fallo que nadie cubre y una rúbrica de decisión sin rodeos.
Los servicios que ejecutas son lo que el monitor vigila. Quizá estás autoalojando Jellyfin en un VPS junto a un forge Git, un par de proyectos secundarios y una copia de seguridad nocturna. Si esa máquina ya ejecuta un PaaS autoalojado como Coolify, Dokploy o Kamal 2, el monitor se instala a su lado en la misma red Docker.
A continuación: la tabla de veredicto en 10 segundos, dos instalaciones funcionales detrás de un proxy inverso, configuraciones lado a lado y qué se rompe a los seis meses.
Uptime Kuma vs Gatus de un vistazo
Primero la respuesta de 10 segundos. Ambas herramientas sondean desde fuera (el mismo trabajo que hace UptimeRobot, menos el SaaS). La verdadera diferencia es quién escribe la configuración y dónde vive.
| Uptime Kuma | Gatus | |
|---|---|---|
| Repo | louislam/uptime-kuma |
TwiN/gatus |
| Estrellas (sep 2026) | ~91.900 | ~12.200 |
| Entorno | Node.js SPA + Socket.IO | Go, un solo binario estático |
| Licencia | MIT | Apache-2.0 |
| Última estable | 2.5.3 (ago 2026) | v5.37.0 (sep 2026) |
| Modelo de config | Interfaz web, estado en SQLite | Archivo YAML, recargado en caliente al cambiar |
| Almacenamiento | SQLite embebido; MariaDB/PostgreSQL en v2 | memory (por defecto), sqlite, postgres |
| Tipos de chequeo | HTTP(s), palabra clave, consulta JSON, WebSocket, ping, DNS, push, Steam, Docker, puerto TCP | HTTP, TCP, UDP, SCTP, ICMP, DNS, WebSocket, salud gRPC, SSH, TLS/STARTTLS, caducidad de dominio |
| Profundidad de aserciones | Ajustes de palabra clave / consulta JSON | Lenguaje de condiciones sobre estado, cuerpo JSONPath, tiempo de respuesta, caducidad de certificado y dominio, rcode DNS |
| Notificaciones | 90+ proveedores | ~40 proveedores |
| Páginas de estado | Varias, cada una asignable a su propio dominio | Una por instancia; la agregación multi-instancia es experimental |
| Autenticación | Usuarios + 2FA TOTP | Auth básica (bcrypt) + OIDC |
| Puerto por defecto | 3001 | 8080 |
| Imagen Docker | louislam/uptime-kuma:2 |
ghcr.io/twin/gatus:stable |
Elección rápida:
- Elige Gatus si tu infraestructura vive en git y quieres que los cambios en los monitores se revisen como pull requests.
- Elige Uptime Kuma si quieres monitorización con clics hoy mismo y una página de estado pública para clientes.
- Ejecutar ambas es un estado final legítimo: Gatus para chequeos internos profundos, Kuma para la página pública.
Si ya has usado cualquiera de las dos herramientas, nada de esa tabla debería sorprenderte. Uptime Kuma ganó la carrera de adopción porque hacer clic en «New Monitor» es un trabajo de 30 segundos y las páginas de estado se ven listas para clientes desde el primer momento. Gatus ganó al público de git porque toda la configuración de monitorización es un único archivo revisable. Los hilos de r/selfhosted que lo debaten («gatus vs uptime kuma reddit» te lleva ahí) se reducen a flujo de trabajo, no a calidad.
Una nota de costes por adelantado: ambas son gratuitas sin nivel de pago obligatorio. Kuma se financia con donaciones, Gatus tiene una oferta gestionada opcional que puedes ignorar. Toda la factura es una porción de un VPS de 4-6 $/mes y algo de disco. Qué porción quieres poseer es el resto de este artículo.
Dos filosofías: una interfaz web vs YAML en git
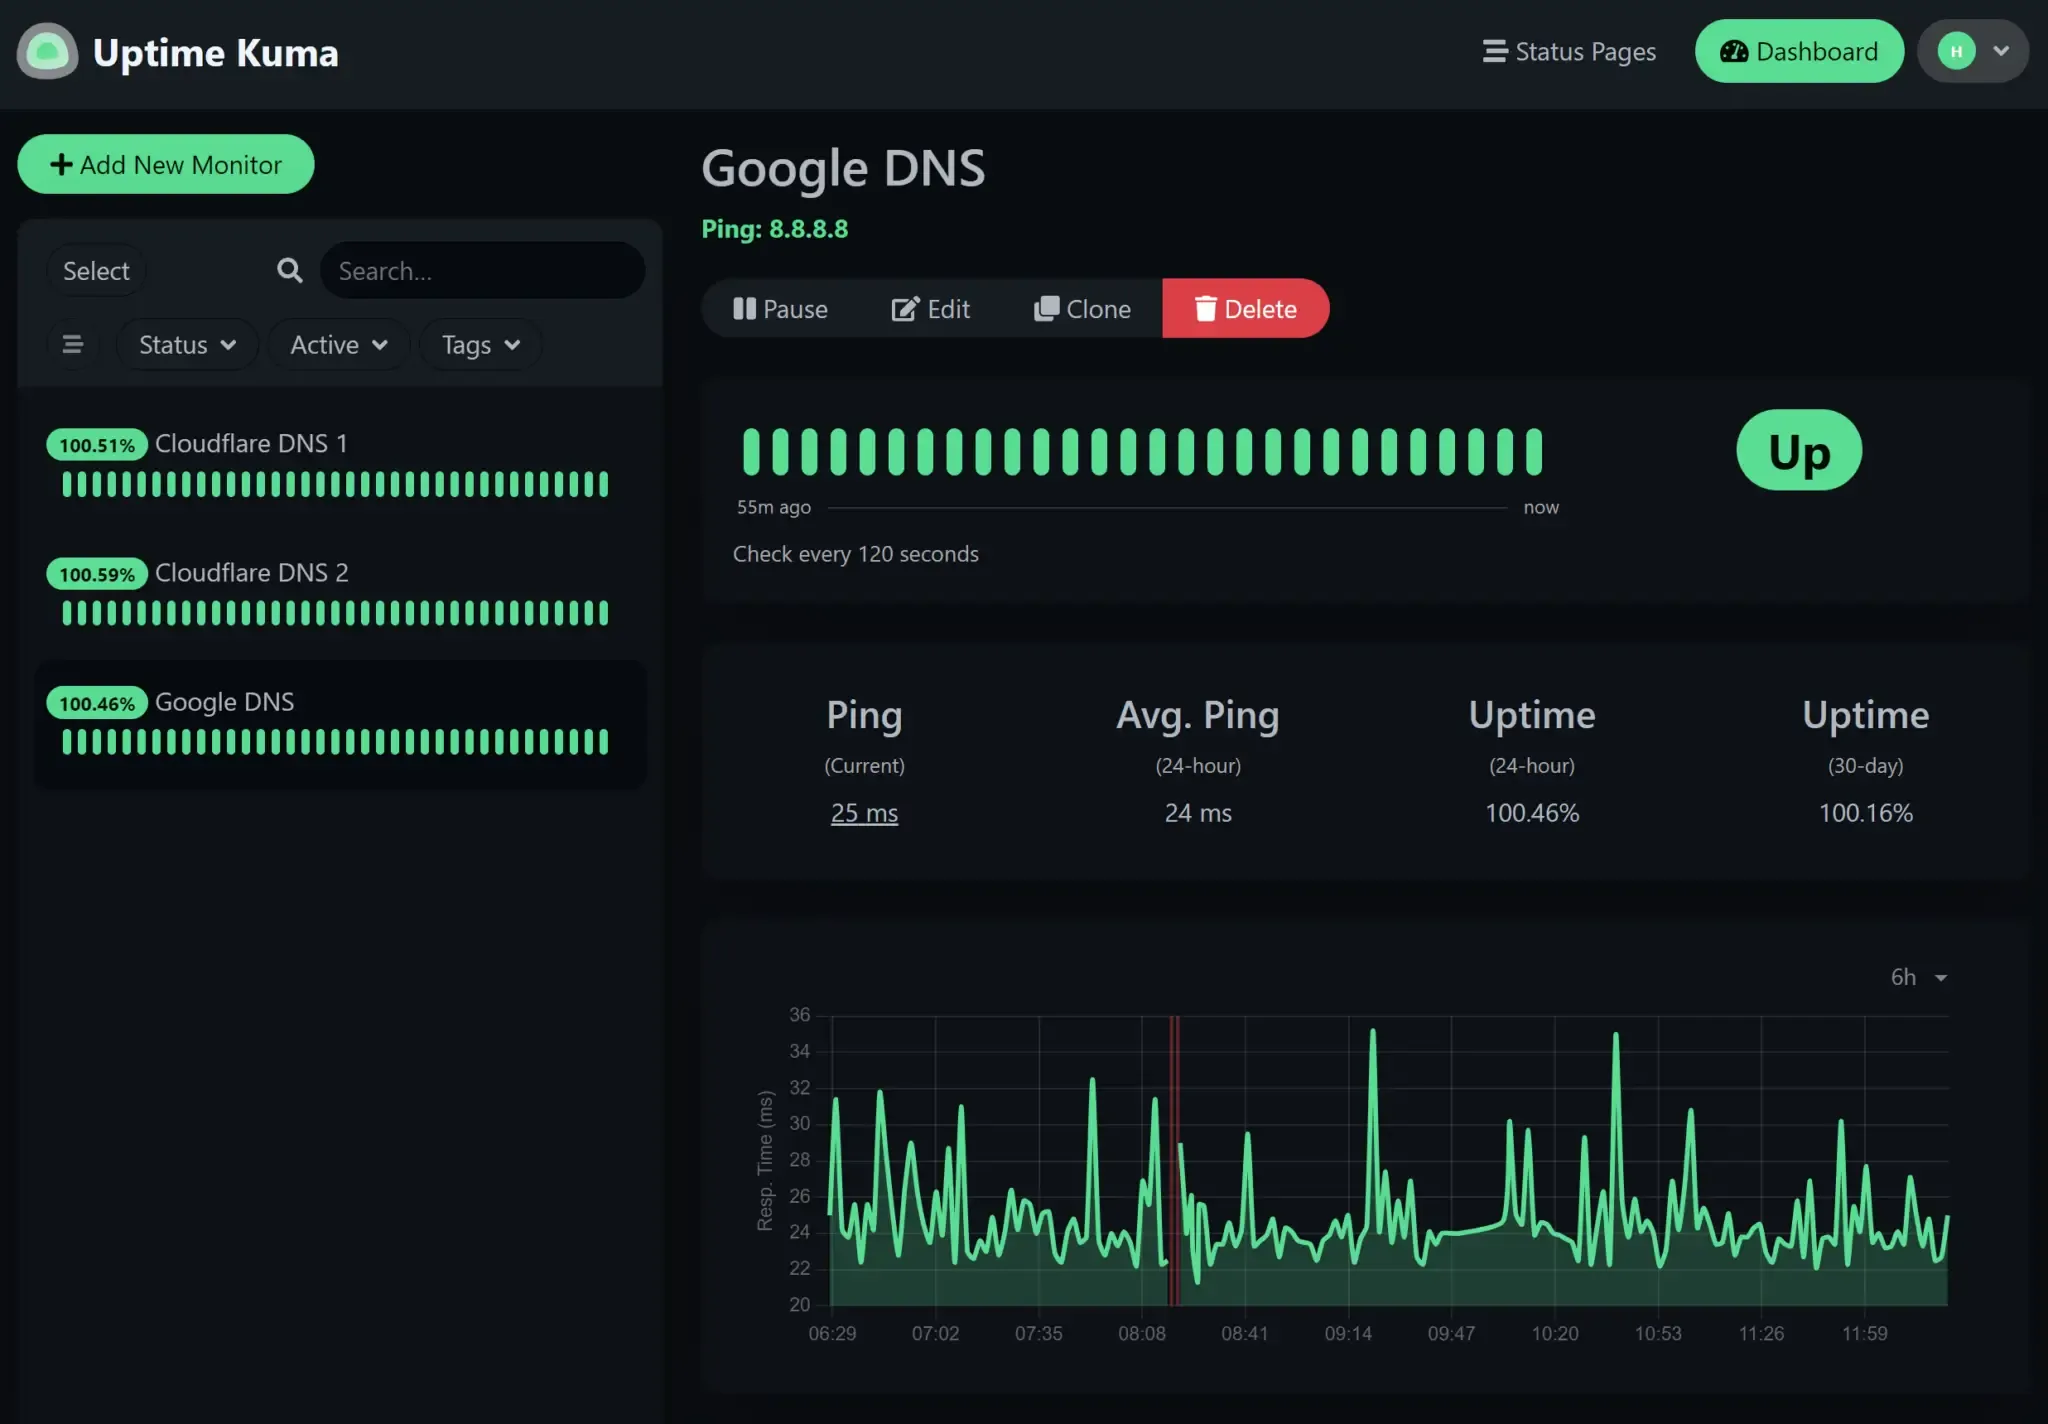
Kuma pone la interfaz primero. Creas monitores con clics, viven en SQLite y el dashboard transmite actualizaciones en vivo por WebSocket. La copia de seguridad significa copiar el directorio data/. Tu configuración de monitorización no admite diff ni revisión, y si ese archivo de base de datos se corrompe sin copia, reconstruyes cada monitor a mano.
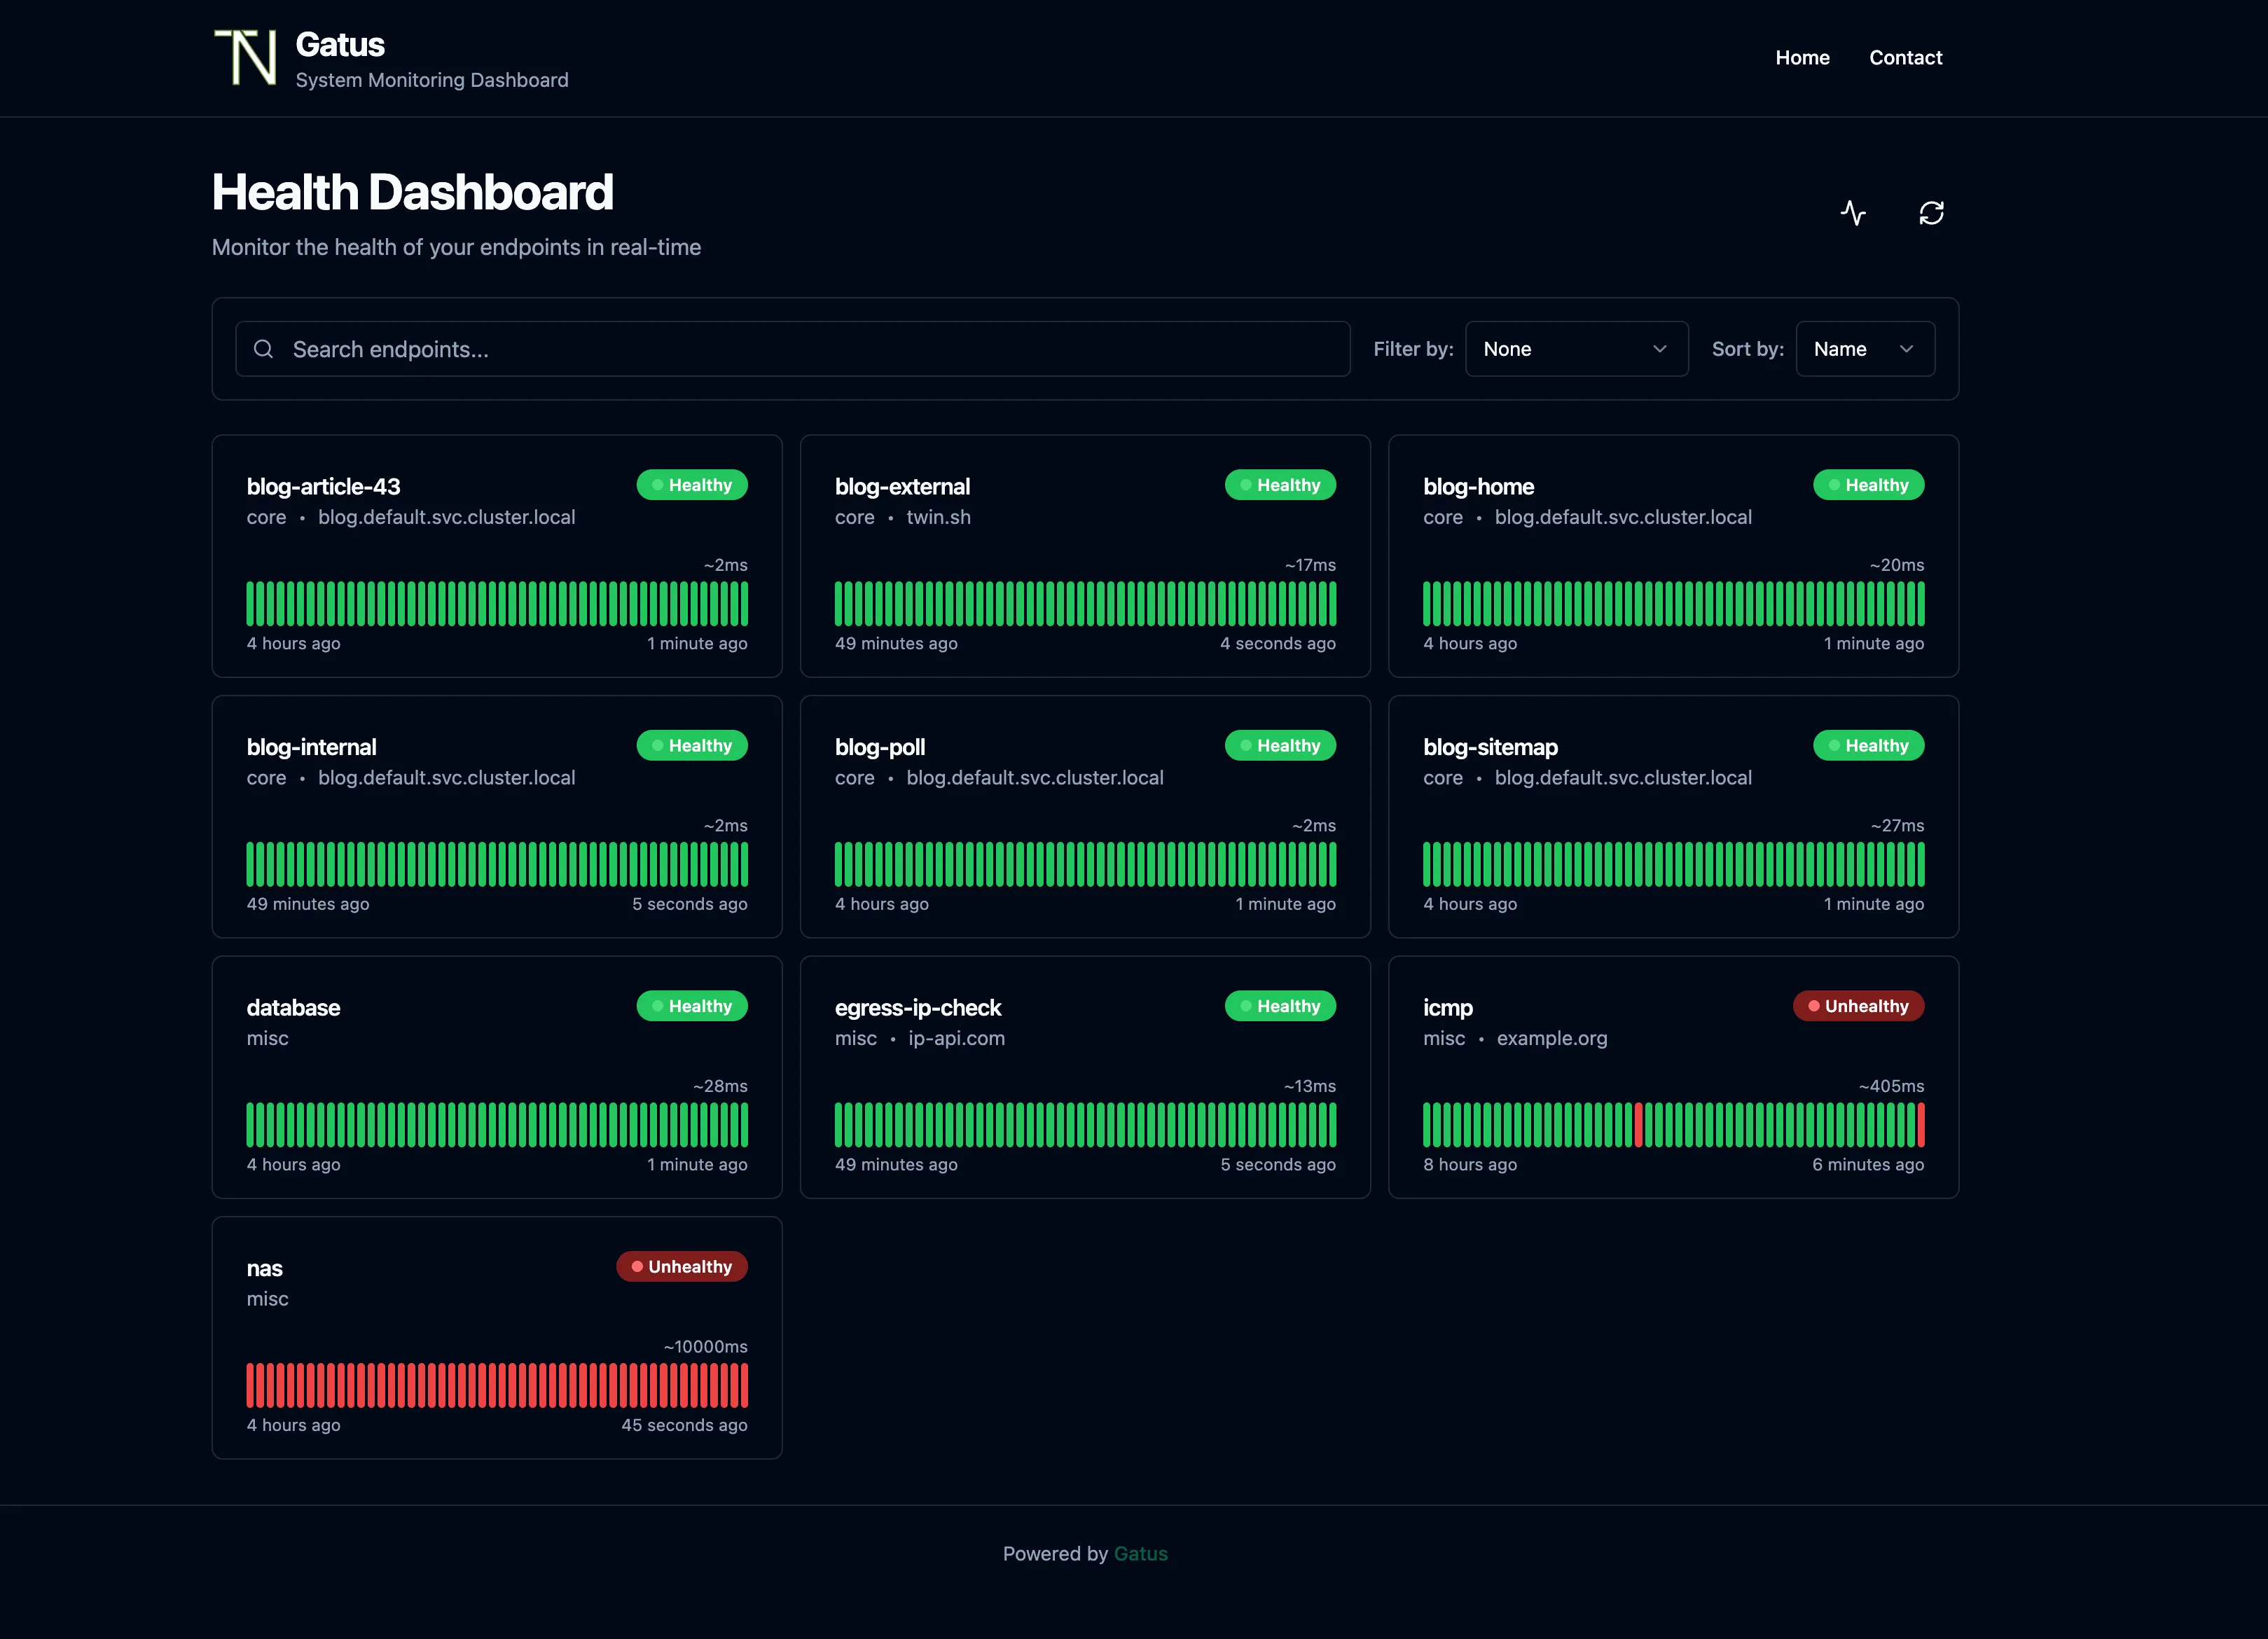
Gatus es configuración como código. Toda la monitorización es un único config.yaml (la config YAML de Gatus que commiteas), recargado en caliente cuando cambia. Revisa los cambios de monitores en pull requests, reviértelos con git revert y restaura todo en una máquina nueva con git clone. Los resultados van a SQLite o Postgres; el dashboard es de solo lectura. Durante años se veía flojo junto a Kuma, pero una renovación de la interfaz en la línea v5 cerró la mayor parte de esa brecha, y los usuarios de r/selfhosted valoran bien el dashboard actual.
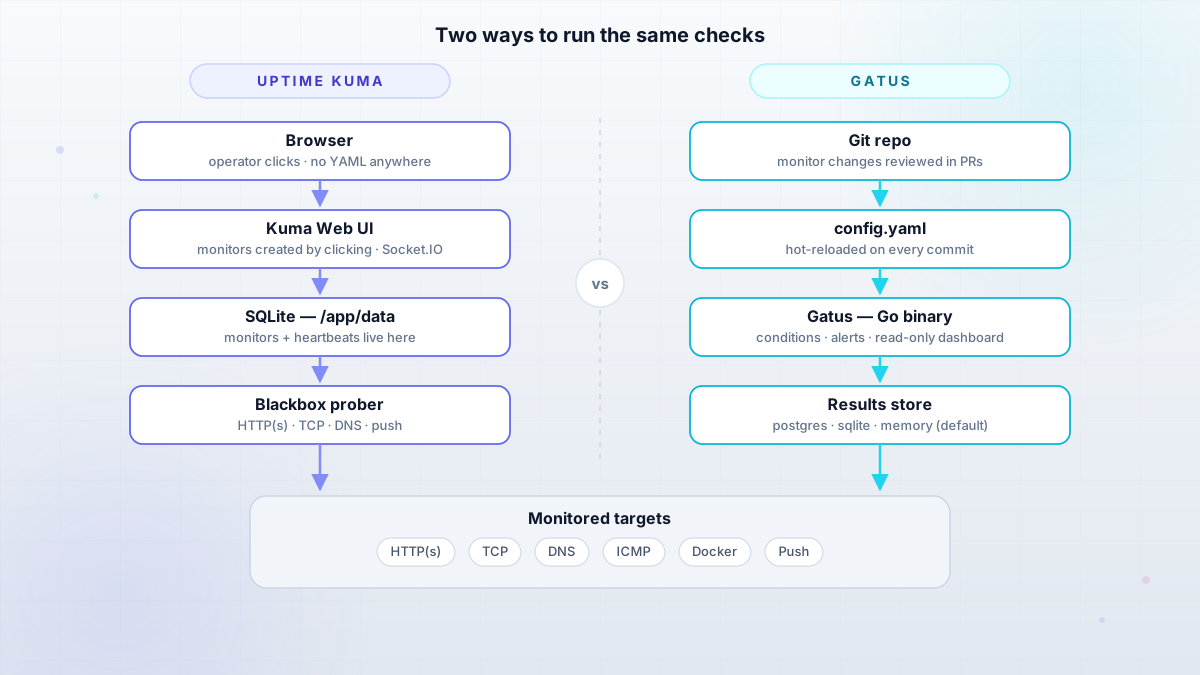
Esto es una elección de flujo de trabajo, no de calidad
La brecha de 91k vs 12k estrellas refleja cuánta gente quiere monitorización por clics, no qué herramienta encaja en un VPS gestionado con git. Si ya autoalojas Git y CI/CD con Forgejo y Woodpecker, los cambios de configuración de Gatus llegan como commits revisados en el mismo flujo de trabajo que el código de tu aplicación.
Ambas son sondeadores de caja negra. Comprueban desde fuera si una URL responde, un puerto conecta, un certificado es válido. Es un trabajo distinto al de las métricas de nodo o las trazas, por eso ambas están más cerca de UptimeRobot que de un node exporter de Prometheus. El README de Gatus lo deja explícito: las pipelines de métricas se quedan en silencio cuando ningún tráfico llega a una app, mientras que un chequeo de caja negra sigue sondeando.
Instalar Uptime Kuma v2 con Docker Compose
Antes de empezar:
- Docker y Docker Compose en un VPS Linux pequeño (Debian 12 / Ubuntu 22.04+)
- Una ruta de volumen local para el directorio de datos (no NFS, ver abajo)
- Unos 200 MB de margen de RAM a escala de homelab
- Un proxy inverso con TLS después (Caddy, Traefik o Nginx)
1 vCPU y 1 GB de RAM bastan para cualquiera de las dos herramientas a esta escala. Vale cualquier máquina barata: un VPS pequeño de Hetzner Cloud, la máquina donde ya vive tu stack de Dokploy, un mini PC de repuesto. No hace falta contenedor de base de datos.
La ruta del README descarga el archivo compose y arranca el stack:
mkdir uptime-kuma && cd uptime-kuma
curl -o compose.yaml https://raw.githubusercontent.com/louislam/uptime-kuma/master/compose.yaml
docker compose up -d
# dashboard on http://localhost:3001 (first run creates the admin account)
Si prefieres un solo comando, y quieres el puerto ligado a localhost porque un proxy estará delante:
docker run -d --restart=always \
  -p 127.0.0.1:3001:3001 \
  -v uptime-kuma:/app/data \
  --name uptime-kuma louislam/uptime-kuma:2
Fija el tag :2
El tag latest de Docker está obsoleto y quedó congelado en la línea v1 para siempre. Fija louislam/uptime-kuma:2 explícitamente (ver la discusión de la deprecación en el issue #6338). Si escribiste tu archivo compose hace tiempo y dice image: louislam/uptime-kuma, corrígelo antes del próximo pull.
NFS no está soportado para el volumen de datos
El almacén SQLite de Kuma sobre un recurso de red corromperá o fallará las escrituras. Solo directorio local o volumen nombrado de Docker. Los directorios de datos montados por NFS son la forma clásica en que la gente pierde esta base de datos.
Verifica la instalación:
docker compose ps        # or: docker ps --filter name=uptime-kuma
curl -I http://localhost:3001
Quieres un HTTP/1.1 200 de curl (un 302 a la página de configuración en el primer arranque también vale), luego abre el dashboard, crea la cuenta de administrador y activa el 2FA (TOTP) ya que estás dentro. Un «contenedor corriendo pero curl se queda colgado» suele significar que el proceso sigue migrando datos. Mira docker compose logs -f.
Actualizar desde v1: el paso a v2 es de un solo sentido y reescribe la tabla de heartbeats. Si tienes una instancia existente, la wiki de migración de Uptime Kuma v1 a v2 es la fuente de verdad. Versión corta:
docker compose down                  # 1. stop
cp -a /path/to/data /backup/data     # 2. back up the data dir (the wiki says: do it three times)
# 3. change the image tag to louislam/uptime-kuma:2
docker compose up -d
docker compose logs -f               # 4. watch the migration; do NOT interrupt it
No interrumpas la migración
La wiki reporta unos 7 minutos para 20 monitores con 90 días de historial, y advierte que «puede tardar horas» en hardware más lento con más datos. Esa cifra es del mantenedor, no un benchmark. Si la migración se interrumpe, restaura la copia de seguridad y reintenta. Cuando termine, confirma que el historial de heartbeats antiguo sigue apareciendo en el dashboard.
Dos trampas más de v2 que conviene conocer antes de actualizar: los hosts Debian/Raspbian Buster chocan con un bug de libseccomp2 y no deben actualizarse in situ, y las instalaciones sin Docker ahora necesitan Node.js 20.4 o superior. Existen imágenes rootless, pero la wiki no recomienda usarlas para una actualización de v1 a v2.
Instalar Gatus con Docker Compose
La instalación de Gatus es un contenedor y un archivo YAML. Los dos métodos de arranque solo difieren en quién gestiona el proceso.
Docker run
mkdir gatus && cd gatus && mkdir config data
$EDITOR config/config.yaml    # paste the config below
docker run -d --name gatus --restart=always \
  -p 127.0.0.1:8080:8080 \
  --mount type=bind,source="$(pwd)"/config,target=/config \
  --mount type=bind,source="$(pwd)"/data,target=/data \
  ghcr.io/twin/gatus:stable
Docker Compose
services:
  gatus:
    image: ghcr.io/twin/gatus:stable
    restart: always
    ports:
      - "127.0.0.1:8080:8080"
    volumes:
      - ./config:/config
      - ./data:/data
    environment:
- GATUS_CONFIG_PATH=/config/config.yamldocker compose up -dEl archivo de configuración es donde vive Gatus. Este config/config.yaml recortado cubre almacenamiento, alertas y dos endpoints:
storage:
  type: sqlite
  path: /data/data.db      # default is memory; history gone on restart

alerting:
  telegram:
    token: "123456:ABC-DEF..."
    id: "0123456789"
    default-alert:
      failure-threshold: 3
      send-on-resolved: true

endpoints:
  - name: bitdoze
    group: public
    url: "https://bitdoze.com"
    interval: 60s
    conditions:
      - "[STATUS] == 200"
      - "[RESPONSE_TIME] < 800"
      - "[CERTIFICATE_EXPIRATION] > 336h"   # fail the check at under 14 days left

  - name: postgres
    url: "tcp://db.internal:5432"
    conditions:
      - "[CONNECTED] == true"
El almacenamiento por defecto es memoria
De fábrica, Gatus guarda los resultados en RAM. Un reinicio borra el historial y el estado de alertas. Configura storage.type: sqlite con un path en un volumen montado (o postgres) antes de confiarle cualquier cosa.
Monta el directorio de config, no el archivo
Monta ./config en /config, no ./config/config.yaml en /config/config.yaml. Los bind mounts de un solo archivo no propagan fiablemente los eventos inotify, así que la recarga en caliente puede perderse tus ediciones por completo (seguimiento en el issue #151). El montaje del directorio es la configuración fiable.
La recarga en caliente puede matar el contenedor
Gatus recarga config.yaml al cambiar y, por defecto, termina ante una actualización inválida. Existe la opción skip-invalid-config-update, pero el autor recomienda dejarla en false para que una config rota falle ruidosamente. Vigila docker compose logs después de cada edición de todos modos.
Unos detalles de configuración que ahorran tiempo de depuración: la sustitución ${ENV_VAR} funciona en el YAML (escapa un signo de dólar literal como $$, lo que muerde cuando pegas URLs de webhook con $), GATUS_CONFIG_PATH apunta a un archivo de config distinto al por defecto, los anchors de YAML funcionan para valores compartidos, y los chequeos [DOMAIN_EXPIRATION] rechazan intervalos menores de 5 minutos para mantenerse lejos de los límites de tasa de WHOIS.
Verifica la instalación:
docker compose ps
curl -I http://localhost:8080
Abre el dashboard y confirma que ambos endpoints de la config aparecen listados y en verde. Luego edita config/config.yaml (añade un comentario) y busca un mensaje de recarga en docker compose logs. Ese viaje de ida y vuelta demuestra que la recarga en caliente realmente vigila el directorio.
Apunte de dimensionamiento: el mismo VPS de 1 vCPU / 1 GB ejecuta esto con comodidad, y si estás buscando una segunda máquina para mantener la monitorización separada de producción, un VPS económico de Hostinger hace el trabajo. Los chequeos ICMP dentro de contenedores necesitaban CAP_NET_RAW en versiones de Gatus anteriores a v5.31.0; desde v5.31.0 el ping sin privilegios funciona salvo que ejecutes el contenedor como root.
Poner ambas detrás de un proxy inverso
La forma de despliegue en este stack es aburrida a propósito: Docker en el VPS, Caddy o Traefik o Nginx delante con TLS, y ambas herramientas ligadas a 127.0.0.1 en compose para que nada responda en la interfaz pública. No publiques 3001 u 8080 en internet y lo des por terminado; ambos dashboards merecen autenticación más TLS más un firewall.
No expongas 3001 u 8080 públicamente
Liga a localhost en compose y deja que el proxy sea dueño del hostname. Luego audita lo que la máquina realmente expone. Ese hábito de auditoría es la idea de securizar un servidor Docker con ufw: Docker escribe sus propias reglas de iptables, y un puerto publicado por descuido pasa de largo ante ufw. Si necesitas el dashboard accesible sin abrir puertos en absoluto, una alternativa autoalojada a Cloudflare Tunnels como Pangolin es el camino más limpio.
El rollback es trivial. Vuelve a poner el mapeo de puertos en 8080:8080, reinicia, y curl http://localhost:8080 funciona otra vez. Nada dentro de ninguna de las herramientas sabe ni le importa el proxy.
Uptime Kuma necesita soporte WebSocket
La interfaz en vivo viaja sobre un WebSocket de Socket.IO de larga duración. Los proxies que cortan conexiones inactivas hacen que el dashboard parezca congelado: la página carga, y luego nada se actualiza. Configura timeouts de lectura de 3600 segundos o más en la ruta del proxy (las configs de referencia de Nginx y Traefik para Kuma lo hacen), y asegúrate de que el proxy reenvía las cabeceras Upgrade y Connection.
Síntoma clásico
El dashboard carga bien pero los heartbeats nunca laten en tiempo real a través del proxy, mientras curl contra localhost sí muestra datos. El proxy está matando el WebSocket. Arregla las cabeceras de upgrade y el timeout de lectura antes de culpar a Kuma.
Verifica: abre el dashboard por el hostname público, dispara un chequeo de prueba y mira la barra de heartbeat moverse sin recargar la página.
Gatus necesita su propio subdominio
Gatus no soporta enrutamiento por ruta. status.example.org funciona; example.org/status/ no (ver el FAQ en el README de Gatus y el issue #88). Basta con proxy HTTP plano, sin requisito de WebSocket.
Las instalaciones en subruta devolverán 404
Si montaste Gatus en /status/ y recibes 404 en assets o en la API, es lo esperado. Muévelo a un subdominio. No pierdas una tarde con reglas de rewrite; la herramienta no genera URLs conscientes de subruta.
Verifica: navega al subdominio y mira el dashboard con resultados de chequeos en vivo. Esa es toda la prueba.
Los mismos cinco monitores, configurados dos veces
Las matrices de características mienten por omisión. Aquí va un stack realista de operador solitario configurado en ambas herramientas para que compares la experiencia: un sitio público, una API con un endpoint de salud JSON, Postgres en un hostname interno, un certificado TLS que te importa y un trabajo de copia nocturna detrás de un firewall. Los mismos cinco monitores, dos filosofías.
Chequeos HTTP con palabra clave y condiciones sobre el cuerpo JSON
Uptime Kuma
Haz clic en New Monitor y elige el tipo:
- HTTP(s) - Keyword: URL
https://bitdoze.com, palabra clavebitdoze(o cualquier cadena que deba aparecer en el cuerpo). Intervalo 60 segundos (el mínimo es 20 segundos). Configura «Max. response time» para rechazar páginas lentas. - HTTP(s) - JSON Query: URL
https://api.example.com/health, consulta JSON$.status, valor esperadook. Así es como afirmas sobre un campo JSON en lugar de raspar texto.
Elige el canal de notificación en la misma pantalla y guarda. El monitor empieza a sondear al instante. Recuerda que los monitores creados en v2 vienen por defecto con retries: 0, así que un solo chequeo fallido puede cambiar el estado; pon retries a 2-3 en cualquier cosa inestable.
Gatus
endpoints:
  - name: bitdoze
    group: public
    url: "https://bitdoze.com"
    interval: 60s
    conditions:
      - "[STATUS] == 200"
      - "[RESPONSE_TIME] < 800"

  - name: api-health
    group: public
    url: "https://api.example.com/health"
    interval: 60s
    conditions:
      - "[STATUS] == 200"
      - "[BODY].status == ok"
      - "len([BODY].dependencies) > 0"
Las condiciones son todo el punto: cada línea debe ser verdadera o el chequeo falla. El lenguaje cubre [STATUS], [BODY] (JSONPath), [RESPONSE_TIME], más helpers como len(), has(), pat() y any() para chequeos de patrón y vacío.
Las aserciones de tiempo de respuesta se corresponden con el campo «Max. response time» de Kuma frente a la línea de condición [RESPONSE_TIME] < 800 de Gatus. Misma intención, distinta superficie.
Chequeos de puerto TCP
Uptime Kuma
Añade un monitor de tipo TCP Port. Host db.internal, puerto 5432, intervalo 60 segundos. Listo. Si Kuma corre en Docker y la base de datos es otro servicio de compose, el hostname tiene que resolver dentro del contenedor (misma red de compose, o una entrada extra_hosts).
Gatus
  - name: postgres
    group: internal
    url: "tcp://db.internal:5432"
    conditions:
      - "[CONNECTED] == true"
Puedes añadir "[RESPONSE_TIME] < 500" si un handshake lento importa. Gatus también hace UDP y SCTP, que Kuma no hace.
La trampa es idéntica en ambas herramientas: el DNS del contenedor. Un «Connection refused» desde dentro de un contenedor casi siempre significa que el hostname no resuelve ahí, no que Postgres esté caído.
Alertas de caducidad de certificados TLS
Uptime Kuma
En cualquier monitor HTTPS, activa Certificate Expiry Notification. Kuma vigila el certificado y te avisa antes de que caduque. El umbral es un ajuste por monitor, separado del chequeo up/down.
Gatus
  - name: bitdoze
    url: "https://bitdoze.com"
    conditions:
      - "[STATUS] == 200"
      - "[CERTIFICATE_EXPIRATION] > 336h"   # 14 days
Esto hace fallar el chequeo cuando quedan menos de 14 días, así que se dispara la alerta normal por umbral de fallos. Es una aserción, no un canal lateral.
Verifica sin esperar a que un certificado real se pudra: pon el umbral de Gatus en algo enorme como 8760h (un año) contra cualquier certificado normal y mira el endpoint ponerse rojo, luego devuélvelo a su valor.
Monitores push e interruptores de hombre muerto
El caso de uso: una copia nocturna detrás de NAT que no puede aceptar chequeos entrantes. Quieres una alerta cuando el trabajo no reporta.
Uptime Kuma
Crea un monitor de tipo Push. Kuma te da una URL push. Haz que el trabajo la llame al final de una ejecución exitosa:
curl "https://status.example.com/api/push/PUSH_TOKEN?status=up&msg=backup+finished"Si no llega ningún push dentro de la ventana de gracia del monitor, Kuma lo marca caído y notifica. Es un interruptor de hombre muerto como debe ser.
Gatus
external-endpoints:
  - name: nightly-backup
    group: internal
    token: "CHANGE_ME_LONG_RANDOM_STRING"   # openssl rand -hex 32
    alerts:
      - type: telegram
        send-on-resolved: true
        failure-threshold: 3
El trabajo envía un estado con el token como cabecera bearer. La clave en la URL es group_name, con espacios y puntuación reemplazados por guiones:
curl -X POST \
  -H "Authorization: Bearer CHANGE_ME_LONG_RANDOM_STRING" \
  "https://status.example.org/api/v1/endpoints/internal_nightly-backup/external?success=true"
Añade &success=false&error=exit+1 en caso de fallo. El watchdog de heartbeat es opcional: si no llega ningún push dentro del intervalo configurado, el endpoint pasa a unhealthy y tus alertas se disparan.
Otras comparaciones se equivocan aquí
Leerás que Gatus no tiene modo push. Sí lo tiene. external-endpoints con un token bearer es exactamente esa escotilla de escape, y está documentado en la documentación de monitorización push de Gatus. Ambas herramientas son pull primero con opción push, así que no elijas por este eje.
Alertas: umbrales, notificaciones y ventanas de mantenimiento
Una alerta en la que nadie confía es ruido. Ambas herramientas permiten amortiguar bien, pero lo expresan de forma distinta.
Uptime Kuma trae más de 90 proveedores de notificación (Telegram, Discord, Gotify, Slack, Pushover, ntfy, SMTP, y sigue). Los retries por monitor controlan cuántos chequeos fallidos pasan antes de una notificación. Ojo al cambio de comportamiento en v2: los monitores nuevos vienen por defecto con retries: 0. Pon 2-3 en cualquier cosa inestable o odiarás al bot en una semana. El interruptor de caducidad de certificado viaja por el mismo canal de notificación.
Gatus trae unos 40 tipos de proveedores (Slack, PagerDuty, Opsgenie, Teams Workflows, Telegram, Discord, ntfy, Gotify, n8n, issues de GitHub y Gitea, webhooks personalizados con placeholders) y lleva la lógica de umbrales a la config: failure-threshold, success-threshold, send-on-resolved y minimum-reminder-interval para el caso «sigue caído, recuerda cada hora». Viven por endpoint o en default-alert.
El mantenimiento también difiere. Gatus tiene ventanas maintenance con zona horaria y días de semana, más maintenance-windows por endpoint para ese servicio que reinicias cada domingo. Kuma tiene pausa por monitor y un concepto de mantenimiento que configuras desde la interfaz.
Gatus ignora en silencio los proveedores mal configurados
Si un proveedor de alertas no está bien configurado, todas las alertas de ese tipo se ignoran. Sin error, sin notificación, sin pista hasta que lo necesitas. Dispara una alerta de prueba real después de cada cambio de alertas. Este es el modo de fallo que hace que la gente piense «Gatus está roto» cuando Gatus está bien y el token está mal.
Kuma v2 cambió las plantillas de email
Las plantillas de notificación SMTP pasaron a LiquidJS en v2 y las variables de plantilla ahora distinguen mayúsculas. Si tus alertas por email llegan vacías tras actualizar, revisa las mayúsculas de las variables en la plantilla.
Protocolo de prueba de alertas (ejecútalo una vez por herramienta, y luego tras cada cambio de alertas):
- Detén el servicio objetivo. Confirma que la alerta se dispara tras el umbral configurado, no en el primer parpadeo.
- Arranca el servicio de nuevo. Confirma que llega la notificación de resuelto (
send-on-resolveden Gatus, el mensaje de recuperación de Kuma). - Reinicia el contenedor de monitorización. Confirma que la config y el historial sobreviven. Aquí es donde aparecen el almacenamiento en memoria de Gatus y los errores de volumen de Kuma.
- Restaura la copia de seguridad en un contenedor nuevo al menos una vez. Una copia no restaurada es una esperanza, no un plan.
docker compose logs en ambos proyectos muestra los intentos de envío de alertas. Si una alerta de prueba no llega, los logs son el primer lugar donde mirar.
Páginas de estado autoalojadas: un dashboard frente a muchas
Aquí es donde las herramientas dejan de parecerse. Una página de estado autoalojada es lo que tus clientes miran durante una caída, y los dos productos lo resuelven de forma distinta.
Uptime Kuma soporta múltiples páginas de estado públicas, cada una con su propia selección de monitores, y cada una asignable a su propio dominio. Es la función que atrae a Kuma a quienes tratan con clientes. Combínala con branding por página y tienes algo que puedes poner delante de un cliente.
Gatus renderiza un dashboard/página de estado por instancia. Soporta anuncios y mensajes de incidente, pero si quieres «una página que muestre tres regiones», la agregación multi-instancia («remote instances») es explícitamente experimental con problemas conocidos (issue #64). No construyas un compromiso con clientes sobre eso todavía.
La autenticación sigue la misma división. Kuma tiene cuentas de usuario con 2FA TOTP para operadores. Gatus tiene auth básica (hasheada con bcrypt, coste 9 recomendado) y OIDC, pero sin 2FA propio, así que el proveedor OIDC tiene que cargar con eso.
De cara al cliente
Usa Uptime Kuma. Construye una página de estado por cliente (o por producto), asigna un dominio personalizado, y deja el dashboard de administración en un hostname distinto con 2FA activado. Kuma es la herramienta elegida cuando personas no técnicas leen la página.
Equipo interno
Usa Gatus detrás de tu SSO. Apunta OIDC a tu proveedor de identidad, liga a un hostname interno y mantén todo fuera de la internet pública. El lenguaje de condiciones da a tu equipo chequeos más profundos que una coincidencia de palabra clave, y nadie fuera de la organización necesita la URL.
Las instancias remotas son experimentales
Gatus puede agregar instancias remotas en una sola vista, pero la función llega con problemas conocidos y una advertencia explícita en el proyecto. Bien para una curiosidad de homelab, no para una página de estado que prometes a clientes.
Almacenamiento, copias de seguridad y qué se rompe a los seis meses
Las copias que no has restaurado son esperanzas
El monitor que no se puede restaurar es una segunda caída. Haz un ejercicio de restauración con la herramienta que elijas, en un directorio de pruebas, esta semana. Toda comparación de estas dos herramientas que se salta la velocidad de restauración se pierde el punto.
A los seis meses, las diferencias son operativas, no funcionales. El disco crece y el VPS se reconstruye tras una actualización fallida. Una errata en la config tira un dashboard a medianoche. Lo que importa entonces: qué tan rápido vuelves a operar, y si queda algo que reconstruir a mano.
Uptime Kuma: crecimiento de SQLite, la migración de v1 a v2 y disciplina de copias
El historial de heartbeats hace crecer el archivo SQLite de Kuma sin límite. Usuarios de r/selfhosted reportan archivos de varios cientos de MB y una lista de monitores lenta en instancias viejas. La versión v2 agrega heartbeats en un formato más denso precisamente para esto, pero no des por hecho que «v2 lo arregló» hasta que tu propia instancia tenga meses de datos.
La migración de v1 a v2 existe por ese cambio de formato. Es de un solo sentido, reescribe la tabla de heartbeats, y la cifra del propio mantenedor es de unos 7 minutos para 20 monitores con 90 días, con la advertencia de que puede tardar horas en hardware más lento. Interrúmpela y restaurarás desde la copia.
La copia de Kuma es a nivel de archivo: el directorio data/ (montado en /app/data en el contenedor). v2 eliminó la vieja ruta de backup/restauración JSON, así que copiar el directorio de datos es el único método soportado. Inclúyelo en tu trabajo nocturno junto al resto de la máquina, por ejemplo con copias autoalojadas con Restic y Rclone. Un destino externo puede ser cualquier cosa con forma de S3; algunos llegan a montar un bucket S3 como sistema de archivos en un VPS para copias de archivo.
Copia el directorio de datos, nunca lo montes en remoto
La exportación JSON se eliminó en v2, así que /app/data es tu único salvavidas. Cópialo a almacenamiento externo; no ejecutes Kuma sobre un montaje de red o FUSE. NFS no está soportado, y un montaje de red lento como directorio de datos en vivo corromperá SQLite igual.
Restaurar es parar, copiar, arrancar. El modo de fallo que duele: un archivo SQLite corrupto sin copia significa recrear cada monitor a clics, porque no hay exportación declarativa que recargar.
Gatus: la trampa del almacenamiento en memoria y la restauración estilo GitOps
Con el almacenamiento memory por defecto, un docker compose restart rutinario borra en silencio tu historial de uptime y el estado de alertas. Vale decirlo claramente porque le muerde a la gente. Configura storage.type: sqlite (o postgres) desde el día uno y monta un volumen en /data.
Hecho eso, Gatus tiene la mejor historia de restauración de esta categoría. La config está en git, así que reconstruir un VPS es git clone y docker compose up -d. El historial es un archivo sqlite que puedes tomar o dejar (un pg_dump si elegiste Postgres). Tu copia de la config de monitorización es literalmente git push.
Una perilla de ajuste importa a escala: concurrency viene por defecto en 3 evaluaciones de endpoints simultáneas (un semáforo deliberado para que las medidas de tiempo de respuesta sigan siendo exactas). Con muchos endpoints y el timeout de 10 segundos por defecto, los chequeos lentos se serializan y distorsionan los intervalos. Sube concurrency deliberadamente, alarga los timeouts en los endpoints lentos, o reparte los chequeos pesados en una segunda instancia. concurrency: 0 desactiva el límite (reemplaza al obsoleto disable-monitoring-lock).
Lo más cercano a HA en esta comparación
Múltiples réplicas de Gatus sobre Postgres es la única historia multi-instancia aquí, y es la razón para considerar Postgres en absoluto. Kuma es de un solo nodo por diseño. Para un VPS solitario, SQLite en todo es la respuesta correcta y aburrida.
Uso de recursos en un VPS pequeño
Ninguna herramienta necesita un contenedor de base de datos a escala individual, y ninguna justifica un VPS más grande. Sáltate Postgres para Gatus salvo que quieras réplicas o un historial muy grande; sáltate una base de datos externa para Kuma hasta que SQLite realmente duela.
Cifras de RAM de orden de magnitud de artículos de terceros: Gatus (un binario Go) unos 20-50 MB en reposo, Kuma (Node.js) unos 100-256 MB. Tómalas como aproximación, no como mediciones. Ejecuta las tuyas:
docker stats --no-streamEso imprime el uso real de lo que haya en esta máquina. Hazlo antes y después de añadir unas decenas de endpoints, así no discutes con un artículo de blog cuando el monitor es lo que está sobre la mesa. Si todo el VPS se siente lento, haz benchmark a tu VPS con YABS primero y separa problemas de disco/red de problemas del monitor.
Dimensionamiento: 1 vCPU / 1 GB de RAM ejecuta cualquiera de las dos con comodidad por debajo de 100 endpoints. Lo que crece es el disco, y solo por el historial de heartbeats. Tras las subidas de precios de VPS de 2026, esto sigue siendo un error de redondeo junto a la factura del VPS. Un VPS de clase CX de Hetzner Cloud es la elección habitual para este tipo de máquina siempre encendida.
Mantenlo en un solo contenedor
Resiste el reflejo del archivo-compose-con-Postgres-Redis-y-una-caché. Un contenedor más un volumen son dos cosas que respaldar y dos cosas que se rompen. Añade una base de datos solo cuando un requisito concreto (réplicas, historial enorme) aparezca por escrito.
Apunte de hardening: configura mem_limit (sintaxis de compose v2, o deploy.resources bajo Swarm) en ambos contenedores para que una tabla de heartbeats desbocada o una sonda atascada no se coman la máquina, y mantén las imágenes fijadas (:2, :stable) para que las actualizaciones ocurran cuando tú decides, no cuando un tag se mueve.
Veredicto: ¿qué herramienta de monitorización autoalojada deberías ejecutar?
Para un operador solitario con un puñado de proyectos secundarios, cualquiera de las dos funciona. Elige por flujo de trabajo, porque es lo que mantendrás en el mes seis.
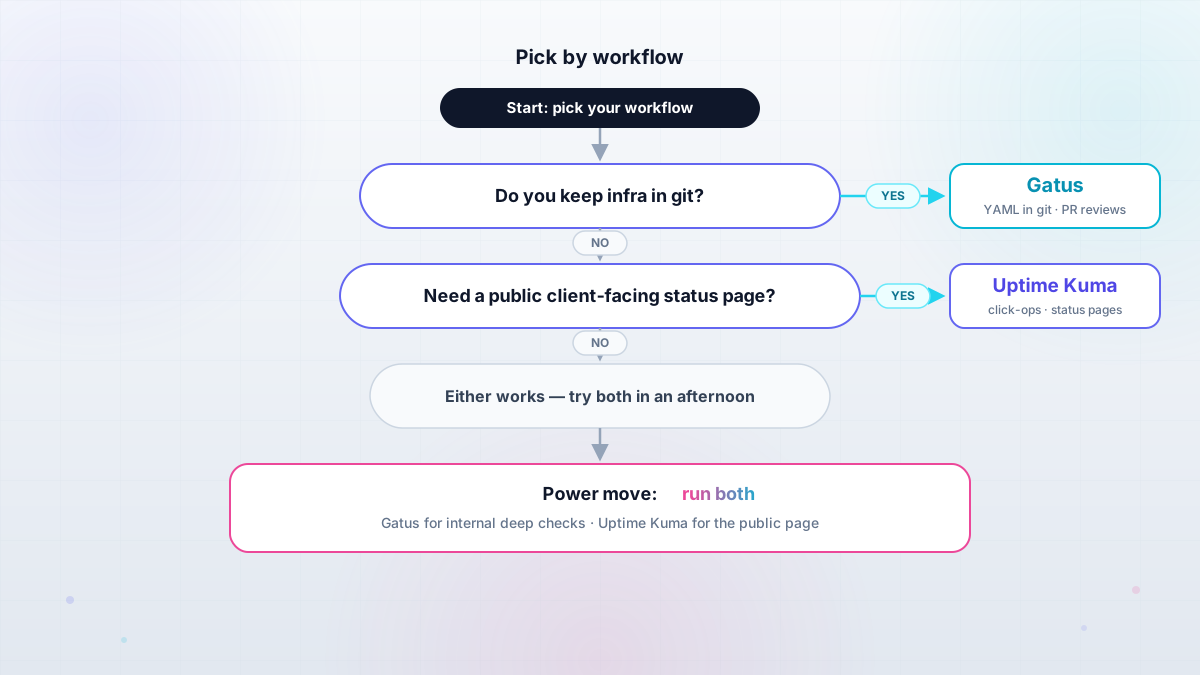
Elige Gatus si:
- Tu infra vive en git, Ansible o repos de compose y los cambios de monitores pertenecen a pull requests.
- Quieres profundidad de condiciones: JSONPath, caducidad de certificado y dominio, rcode DNS, chequeos por comandos SSH.
- La RAM es escasa y quieres un binario Go estático de decenas de MB.
- La velocidad de restauración tras una reconstrucción importa más que una página pública bonita (git clone y listo).
- Quizá ejecutes réplicas sobre Postgres algún día.
Elige Uptime Kuma si:
- Quieres monitorización hoy, configurada con clics, sin apetito de YAML.
- Una página de estado pública de cara al cliente es parte del trabajo, y quizá necesites varias en dominios distintos.
- Importan el 2FA en el dashboard y más de 90 proveedores de notificación de fábrica.
- Tu flujo de trabajo es un navegador, no un commit de git, y te va bien respaldar un directorio de datos.
Y sí, ejecutar ambas es legítimo. Gatus para chequeos internos y profundos (puertos, contratos JSON, caducidad de certificados, heartbeats push desde cron), Kuma para la página de estado pública y los heartbeats bonitos. Dos herramientas de un solo contenedor en una máquina siguen siendo menos piezas móviles que la mayoría de stacks de observabilidad «todo en uno».
Sobre la objeción de «91k estrellas significa que gana Kuma»: la adopción cuenta la mayoría de clics. No sabe si tu infraestructura vive en git. Si vive, la herramienta YAML es con la que seguirás contento cuando el dashboard no esté abierto.
Coste total de cualquiera de los dos caminos: menos de 300 MB de RAM combinados, una porción de un VPS de 5 $, y los 20 minutos de instalación más la rutina de copias que ibas a montar de todos modos.
Mira cómo encaja esto en un stack Dokploy / TraefikCuando ninguna encaja: Prometheus Blackbox Exporter
Si ya ejecutas Prometheus y Grafana y quieres que el sondeo alimente dashboards y reglas de Alertmanager en lugar de una página de estado dedicada, el Prometheus Blackbox Exporter es la herramienta con la forma correcta. Obtienes objetivos sondeados como métricas de scrape, y ensamblas las alertas y la visualización de estado tú mismo. Ese ensamblaje es exactamente el trabajo que Kuma y Gatus hacen por ti, así que elige el exporter solo cuando ya vivas en ese ecosistema.
La monitorización de uptime no es observabilidad
Saber «el sitio está caído» es un trabajo. Saber por qué (trazas, métricas, logs) es otro. Si necesitas el segundo trabajo, mira Traceway, una alternativa autoalojada a Datadog, y conserva la herramienta de uptime igualmente: se complementan.
Para todos los demás, las dos herramientas de este artículo son más simples de instalar y restaurar, y traen una página de estado sin el desvío por PromQL.
FAQ: Uptime Kuma vs Gatus
¿Es Gatus mejor que Uptime Kuma?
¿Mejor en qué? Gatus es mejor cuando tu config de monitorización debe vivir en git y cuando necesitas aserciones a nivel de condición sobre cuerpos JSON, certificados o respuestas DNS. Uptime Kuma es mejor cuando quieres el camino más rápido a la monitorización y una página de estado pública multipágina. Ninguno es «mejor» en abstracto. Elige por flujo de trabajo, que es todo el argumento de este artículo.
¿Gatus tiene interfaz web?
Sí. Gatus renderiza un dashboard que muestra cada endpoint, barras de uptime, tiempos de respuesta y funciones de página de estado como anuncios. Es de solo lectura para configuración (el YAML es la fuente de verdad), y la renovación visual de la línea v5 arregló la mayoría de las quejas de «feo junto a Kuma» que aparecían en r/selfhosted.
¿Por qué mi Uptime Kuma va lento o el archivo SQLite es enorme?
El historial de heartbeats se acumula y el archivo SQLite crece con él. Hilos de r/selfhosted reportan archivos de varios cientos de MB y lag en la lista de monitores en instancias viejas. Kuma v2 agrega heartbeats en un formato más denso dirigido a esto, así que actualizar a louislam/uptime-kuma:2 es el primer paso, y luego observa tu propia instancia durante semanas en lugar de confiar en cualquier blog. Mantén el directorio de datos respaldado, y nunca lo pongas en NFS.
¿Puede Gatus recibir heartbeats push?
Sí. external-endpoints en config.yaml define un endpoint que Gatus no sondea; en su lugar tu trabajo envía un estado vía POST /api/v1/endpoints/{group}_{name}/external con un token bearer, opcionalmente con parámetros success, error y duration. Un watchdog de heartbeat opcional marca el endpoint como unhealthy si los pushes dejan de llegar, lo que lo convierte en un interruptor de hombre muerto de verdad para trabajos cron detrás de un firewall. Algunas comparaciones afirman que Gatus no tiene modo push; la documentación oficial dice lo contrario.
¿Uptime Kuma v2 cambia cómo hago copias de seguridad?
Sí. v2 eliminó el backup/restauración JSON, así que copiar el directorio data/ es el único método soportado. La migración de v1 a v2 es de un solo sentido y reescribe la tabla de heartbeats, así que haz primero una copia completa del directorio de datos (la wiki de migración sugiere hacerlo tres veces) y no interrumpas la migración una vez iniciada. Restaurar es parar el contenedor, reemplazar el directorio, arrancar el contenedor.
¿Puedo ejecutar Uptime Kuma y Gatus juntos?
Sí, y muchos operadores lo hacen. División típica: Gatus se encarga de los chequeos internos y profundos (puertos TCP, contratos de salud JSON, caducidad de certificados, heartbeats push de trabajos batch) mientras Kuma se encarga de la página de estado pública con sus heartbeats y dominios personalizados. Ambos son contenedores únicos, ambos corren en el mismo VPS de 5 $, y no se pisan los puertos ni el almacenamiento.