---
title: "El Mejor Mini PC para LLMs Locales y Ollama (2026)"
description: "El mejor mini PC para Ollama en 2026 es el GMKtec EVO-X2 con 128GB. Qué ejecuta un Ryzen AI Max+ 395, además de alternativas con 10GbE y CUDA, con precios del 21 de septiembre."
date: 2026-09-21
categories: ["ai"]
tags: ["ollama","local-llm","mini-pc"]
---
import Notice from "@components/widgets/Notice.astro";
import Accordion from "@components/widgets/Accordion.astro";
import Button from "@components/widgets/Button.astro";
import AmazonProduct from "@components/widgets/AmazonProduct.astro";
Compra el [GMKtec EVO-X2 con 128GB](/go/gmktec-evo-x2-128gb/) si quieres un mini PC capaz de cargar un modelo de 70B en Ollama. Es un Ryzen AI Max+ 395 con 128GB de LPDDR5X-8000 soldados en la placa, a $3,499.99 el 21 de septiembre de 2026. El chip no es rápido con un 70B denso. Es la primera caja pequeña en la que ese modelo cabe sin una GPU de centro de datos.
Algunos enlaces de abajo son enlaces de afiliado de Amazon, incluidas las redirecciones `/go/` que llevan a Amazon. Comprar a través de ellos me genera una pequeña comisión sin coste adicional para ti. Los precios se comprobaron el 21 de septiembre de 2026 y cambian constantemente, así que confírmalos en la página del producto.
## Selección rápida
| Mini PC | Precio (21 sep. 2026) | Memoria | Red | Cómpralo si |
| --- | --- | --- | --- | --- |
| [GMKtec EVO-X2 128GB](/go/gmktec-evo-x2-128gb/) | $3,499.99 | 128GB LPDDR5X-8000, soldada | 2.5GbE | Quieres una sola caja para modelos de 70B y MoE de la clase de 120B. |
| [GMKtec EVO-X2 64GB](/go/gmktec-evo-x2-64gb/) | $2,199.99 | 64GB, soldada | 2.5GbE | 32B es el modelo más grande que vas a ejecutar. |
| [MINISFORUM MS-S1 MAX 128GB](/go/minisforum-ms-s1-max-128/) | $3,799 | 128GB LPDDR5X, soldada, SSD de 2TB | Doble 10GbE, PCIe x16 | El mismo chip, y la caja además alimenta un NAS. |
| [Beelink GTR9 Pro](/go/beelink-gtr9-pro/) | $4,349 | 128GB, 2TB | Doble 10GbE | Quieres específicamente el chasis de Beelink. Yo no. |
| [NVIDIA DGX Spark](/go/nvidia-dgx-spark/) | $4,999.99 | 128GB unificada, 4TB | ConnectX-7 | Necesitas CUDA, no solo Ollama. |
| [Mac Studio M5 Max](/go/mac-studio-m5-max/) | $2,499 en preventa | 36GB en esta SKU | Cuatro puertos Thunderbolt 5 | Quieres macOS. Esta SKU no aloja un 70B. |
La lista de compra más amplia para equipos que no son máquinas de LLM está en la [guía de mini PC para servidor doméstico](/best-mini-pc-home-server/). Esta página solo va de tokens.
## Empieza por el modelo
La caja de $3,500 es una mala compra para mucha gente que llega a esta página. Ajusta el gasto al modelo antes de ajustarlo a una marca. Los [modelos open source que merece la pena ejecutar](/es/mejores-llms-opensource-alternativa-claude/) son la otra mitad de esa decisión.
| Lo que ejecutas | Memoria que necesita | Compra |
| --- | --- | --- |
| Chat de 8B a 14B, un modelo a la vez | Menos de 16GB | Para. Un [N150 o AI X1 Pro](/best-mini-pc-home-server/) es suficiente, o una GPU de 16GB usada. |
| 32B como modelo diario, prompts cortos | Unos 20GB en Q4 | EVO-X2 64GB por $2,199.99. No usarás el resto de una placa de 128GB. |
| Un 70B, o un 32B con un prompt largo, o dos modelos cargados a la vez | 42GB de pesos antes del contexto | EVO-X2 128GB. En 64GB un 70B Q4 carga y luego pelea con el SO. |
| Un modelo de mezcla de expertos de 120B | Unos 65GB de pesos | Solo 128GB. La SKU de 64GB no puede alojarlo. |
| Herramientas CUDA, TensorRT, un bucle de entrenamiento | 128GB ayuda, pero pesa más la pila de software | DGX Spark, no otra pegatina de Strix Halo. |
| Ya vives en macOS y quieres MLX | La memoria unificada de la configuración, no el nombre del chip | Un Mac con mucha memoria. La preventa del M5 Max de $2,499 es de 36GB. |
El contexto es la parte que la hoja de especificaciones omite. Un 70B Q4 son unos 42GB de pesos. El prompt y la respuesta se suman a eso. Las [notas de Promptquorum del 29 de agosto de 2026](https://www.promptquorum.com/prompt-bites/strix-halo-ollama-vulkan) sitúan un modelo de 30B con contexto de 64K a 96K en unos 36 a 45GB en total. Eso aún cabe en 64GB. Lleva la misma idea a un 70B con un documento largo y el margen desaparece. Si «puede que pegue un repositorio entero» es el uso, compra 128GB. Si los prompts son un párrafo, 64GB es el gasto honesto.
La electricidad es el otro número que la gente olvida porque la caja es pequeña. El botón de encendido de GMKtec ofrece 54W, 85W o 120W de potencia de paquete. A $0.16 por kWh, dejarlo en Equilibrado las 24 horas cuesta unos $10 al mes (vatios × 0.72 × tu precio por kWh). Silencioso cuesta unos $6, Rendimiento unos $14. Eso es potencia de paquete, así que en el enchufe será algo más. Aun así, no es motivo para elegir otro Strix Halo. Es un motivo para no comprar esta clase de máquina para responder «qué tiempo hace» con un modelo de 8B.
## Ancho de banda, no TOPS
Cada listado del Ryzen AI Max+ 395 presume de 50 TOPS de NPU, o 126 TOPS si le suman la CPU y la GPU. Ollama y llama.cpp no usan ese NPU. Funcionan sobre la Radeon 8060S, y la generación de tokens está limitada por la velocidad a la que los pesos se pueden leer de la memoria.
La memoria es el producto. La plataforma Strix Halo de AMD usa un bus LPDDR5X-8000 de 256 bits, especificado a 256 GB/s. El [análisis de ModelFit de septiembre de 2026](https://modelfit.io/gpu/ryzen-ai-max-395/) sitúa el ancho de banda medido más cerca de 215 GB/s, y dice que Linux puede asignar a la iGPU unos 110GB de un pool de 128GB. En Windows, la BIOS reserva una porción fija, así que el truco de los modelos grandes es una instalación de Linux.
Su modelo de ancho de banda, que ellos mismos etiquetan como estimación y no como benchmark, queda así para Q4:
| Modelo | Tamaño aprox. de pesos | EVO-X2 64GB | EVO-X2 128GB | Su estimación de velocidad |
| --- | --- | --- | --- | --- |
| 8B denso | ~6GB | Cómodo | Cómodo | ~30 tok/s |
| 32B denso | ~20GB | Bien | Bien | ~9 tok/s |
| 70B denso | ~42GB | Carga, contexto corto | Sí, con margen para contexto | ~5 tok/s |
| GPT-OSS 120B (MoE) | ~65GB | No | Sí | ~11 tok/s |
Cinco tokens por segundo en un 70B denso es un ritmo de lectura, no de charla. Las mediciones Vulkan de Promptquorum sobre el mismo chip quedan aún más abajo, unos 3 tok/s para Llama 3.3 70B y unos 7 tok/s para un 32B. Los dos análisis discrepan en el entero exacto y coinciden en la forma: el 70B denso es lento, y un modelo de mezcla de expertos se siente mejor porque solo unos pocos miles de millones de parámetros están activos por token. Si necesitas 70B a 40 tok/s, este no es el formato de ordenador correcto. Una GPU usada de 24GB sigue ganando en todo lo que quepa en 24GB. El mini PC gana cuando el modelo no cabe en ninguna GPU de consumo.
Yo no citaría ninguno de los dos sitios como una promesa. ModelFit extrapoló desde el ancho de banda. Promptquorum es una sola configuración Vulkan. Ejecuta `ollama ps` en tu propio equipo antes de darle la cifra a nadie.
## El debate después de que la gente lo compre
El chip es el mismo en el EVO-X2, el MS-S1 MAX, el GTR9 Pro y el Framework Desktop. Cuando eso se asimila, los hilos dejan de hablar de TOPS y empiezan a hablar de todo lo que rodea al silicio.
Un resumen de junio de 2026 que probó varias de estas cajas eligió el MS-S1 MAX, y las razones eran aburridas: doble 10GbE, USB4 v2, fuente de alimentación interna y una ranura PCIe de bajo perfil que los demás omitieron ([@plutos_eth](https://x.com/plutos_eth/status/2067390150057869538)). El mismo post señaló la división de memoria de la BIOS. Cuántos gigabytes entregas a la GPU y cuántos dejas a la CPU mueve el rendimiento de la CPU en silicio por lo demás idéntico. Maximizar la asignación de la GPU no es gratis. Deja a la CPU lo suficiente para alimentar el modelo o el procesamiento del prompt empeorará mientras la cifra de tokens de la caja sigue quedando bonita.
La medición más afilada está en r/LocalLLaMA. NeverEnPassant ejecutó llama.cpp con gpt-oss-120b, unos 59GB con la mayor parte en capas de expertos, y publicó las cifras de Strix Halo de otras personas junto a una 5090 que tuvo que mantener parte de esos expertos en DDR5 normal ([el hilo](https://www.reddit.com/r/LocalLLaMA/comments/1oonomc/why_the_strix_halo_is_a_poor_purchase_for_most/)):
| | Strix Halo, contexto corto | Strix Halo, contexto de 48k | 5090 más RAM del sistema, contexto de 48k |
| --- | --- | --- | --- |
| Procesamiento del prompt | unos 1,013 tok/s | unos 231 tok/s | unos 2,497 tok/s |
| Decodificación | unos 52 tok/s | unos 33 tok/s | unos 35 tok/s |
La decodificación en un modelo grande de mezcla de expertos puede parecer correcta. El primer prompt largo, no. El prefill cae a medida que crece el contexto, que es exactamente el flujo de trabajo de agentes en el que una herramienta relee un repositorio desde cero en cada tarea. Un propietario de un MS-S1 MAX en ese hilo dijo que un contexto de 100k en un modelo de 120B tardó una eternidad la primera vez y fue tolerable después, porque la caché ya estaba caliente. Si tu uso es un modelo que permanece cargado y una conversación que continúa, la caja Halo es lo que esos propietarios conservan, y la conservan porque es una sola máquina de la clase de 120W en lugar de una GPU de 575W. Si cada trabajo es un arranque en frío con un prompt enorme, esta compra se sentirá rota y una GPU dedicada con un poco de offload no.
Un gráfico de presupuestos de septiembre de 2026 que circuló por X puso la misma división en dinero: una tarjeta NVIDIA usada de 24GB para los modelos que caben, un Strix Halo de 128GB alrededor de $3,700 cuando quieres memoria, un DGX Spark alrededor de $4,700 cuando quieres CUDA, con el ancho de banda de memoria del Spark listado ahí en 273 GB/s frente a los 256 del Halo ([@0xSero](https://x.com/0xSero/status/2100961254890217807)). Las quejas de ese gráfico coinciden con el hilo. El punto débil del lado de AMD es la compatibilidad de modelos. El del Spark es una decodificación que no es tan rápida como sugiere la historia de CUDA. Yo no trataría ninguno de los dos gráficos como un benchmark que ejecuté. Trataría su forma como la decisión.
Framework es el caso raro y sigo sin poder ponerle precio desde Amazon. Las notas de Ian Cutress del lanzamiento daban a la placa de 128GB una cifra mucho menor que los mini PC de hoy, con 5GbE en lugar de 2.5GbE, y la placa base se vende por separado para que puedas reemplazarla o colgar más de una de un switch ([el post de lanzamiento](https://x.com/IanCutress/status/1894484317503361442)). Ese precio es de febrero de 2025. Confirma el configurador actual. La razón para mirarlo es la placa reparable y la Ethernet más rápida, no la esperanza de que el precio antiguo siga ahí.
## 1. GMKtec EVO-X2 128GB: la opción por defecto
**$3,499.99** · 4.6 estrellas de 38 valoraciones · 128GB LPDDR5X-8000 · SSD de 1TB · Ryzen AI Max+ 395

Esta es la configuración que yo compraría. La RAM está soldada. No hay una actualización posterior de 64GB a 128GB, y esa es toda la decisión.
El listado de GMKtec describe el chip como 16 núcleos Zen 5, 32 hilos, boost hasta 5.1GHz, Radeon 8060S con 40 unidades de cómputo RDNA 3.5, y un NPU XDNA 2 de 50 TOPS que puedes ignorar para Ollama. Un botón en la caja cambia la potencia de paquete entre Silencioso 54W, Equilibrado 85W y Rendimiento 120W, con picos cortos hasta 140W. Dos ranuras M.2 2280, una ocupada por el disco de 1TB y la segunda vacía, cada una soporta hasta 8TB. La salida de vídeo es HDMI 2.1, DisplayPort 1.4 y dos puertos USB4 a 40Gbps. La [guía de servidor doméstico](/best-mini-pc-home-server/) midió la Ethernet de esta plataforma como un único Realtek RTL8125BG a 2.5GbE. Bien para descargar un modelo una vez. Molesto si la misma caja es también tu servidor de archivos.
La SKU de 64GB cuesta $2,199.99 y tiene más valoraciones (4.3 de 69, vendida por GMKtec-Shop, en stock ese día). Cómprala cuando 32B sea el trabajo y estés seguro de que no te picará la curiosidad por 70B. Un 70B Q4 son unos 42GB de pesos antes del contexto. En 64GB carga y luego pelea con el SO por el resto.
Antes de pagar $3,499.99, lee los gigabytes en el nombre de la variación y luego la línea del vendedor. Los EVO-X2 de 64GB y 128GB son listados separados gestionados por dos tiendas distintas del marketplace, GMKtec-Shop y GMKtec一Store, cada una con su propio selector de variaciones. Ninguna de las dos es Amazon.com. Comprueba también la ventana de devolución. Un pedido de marketplace de $3,500 con una ventana de devolución corta es un riesgo distinto al de un switch de $60.
## 2. MINISFORUM MS-S1 MAX: mismo chip, red de verdad
**$3,799** por 128GB y un SSD de 2TB · 4.5 estrellas de 16 valoraciones · doble 10GbE · PCIe x16 · USB4 v2
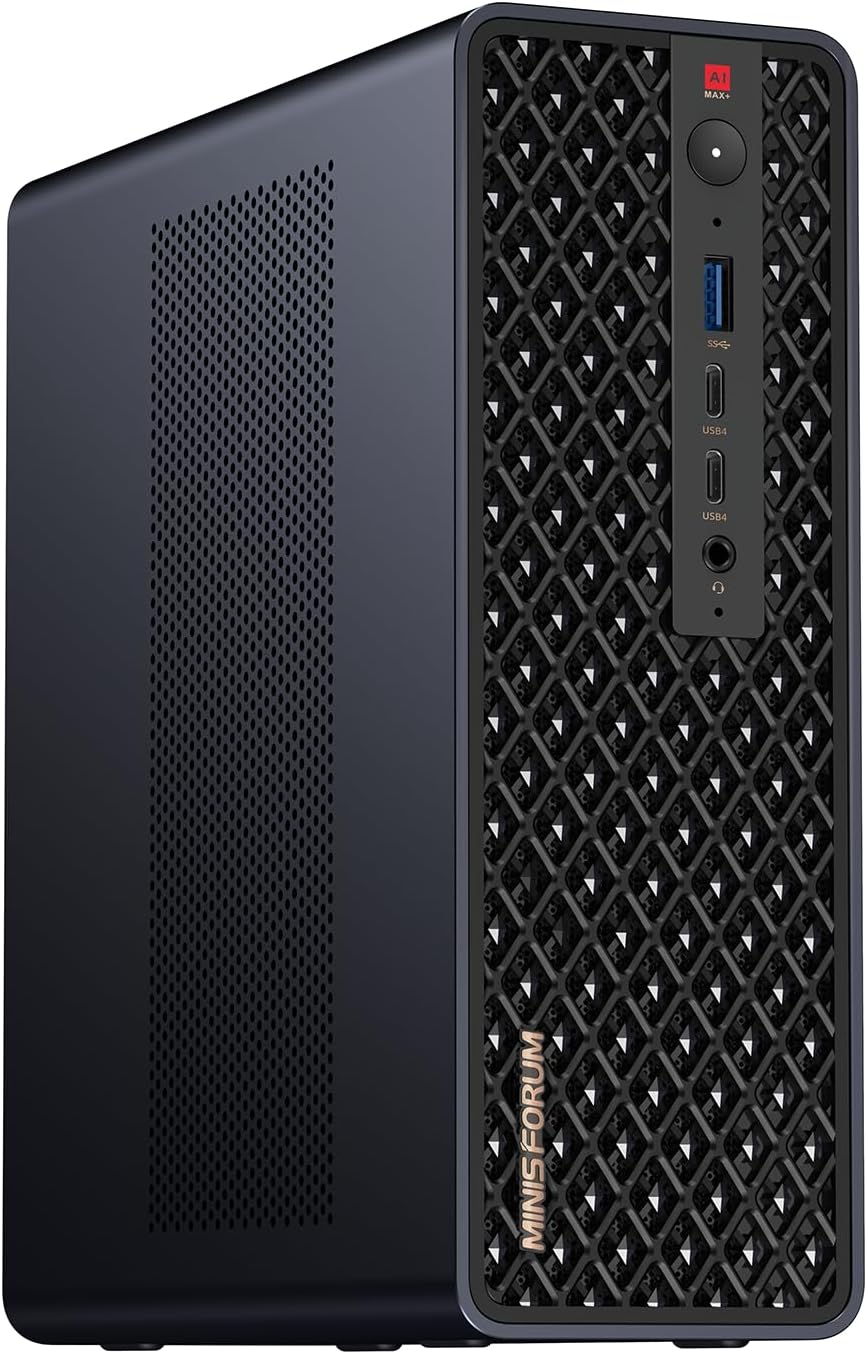
La misma APU, $300 más que el EVO-X2, y el dinero extra se nota en el panel trasero. MINISFORUM lista doble 10GbE, una ranura PCIe x16 de tamaño completo, USB4 v2 a 80Gbps, HDMI 2.1 y un SSD de 2TB. Hay una variante de 64GB / 2TB por $2,599.
Yo lo compraría en lugar del EVO-X2 solo si la máquina tiene un segundo trabajo. Apunta un puerto 10GbE a un [NAS](/best-nas-homelab-docker-proxmox/) o a un [switch 10GbE](/es/mejores-switches-2-5-10gbe-homelab/) y las cargas de modelos dejan de competir con un Realtek de 2.5GbE. La ranura PCIe está ahí por si luego le metes una NIC o un pequeño acelerador. Dieciséis valoraciones no son una reputación. La afirmación de refrigeración (placa de cobre, seis heat pipes, doble ventilador soplador) es el fabricante hablando.
## 3. Beelink GTR9 Pro: misma memoria, precio más alto
**$4,349** · 4.1 estrellas de 289 valoraciones · 128GB / 2TB · doble 10GbE · quedaban 5 en stock el 21 de septiembre

El GTR9 Pro es otro Ryzen AI Max+ 395 con 128GB. El propio nombre de variación de Beelink es 395 / 128GB / 2TB, y las viñetas incluyen dos puertos 10GbE. El número de reseñas es el más sano de los tres, y un 4.1 de 289 personas es una muestra real, no una pila de posts de una estrella de la semana de lanzamiento.
El precio es el problema. Cuesta $849 más que el EVO-X2 de 128GB y $550 más que el MS-S1 MAX de 128GB, que también tiene doble 10GbE y añade una ranura PCIe. Las historias de soporte son el otro problema. En r/BeelinkOfficial, un propietario de un GTR9 Pro recomendó reconsiderar la compra después de que el puente USB4 muriera tras cambios de drivers y firmware, además de desajustes de firmware y problemas con AMDGPU ([el aviso](https://www.reddit.com/r/BeelinkOfficial/comments/1o0bv49/psa_please_reconsider_before_buying_from_beelink/)). Otro hilo allí cuestiona cómo el recuento de reseñas de Amazon se volvió tan sano tan rápido. Yo solo lo compraría con un descuento fuerte de un vendedor con una ventana de devolución normal, y no sería yo quien aplicara la primera actualización de firmware un viernes.
## 4. DGX Spark, Framework y el Mac Studio
Tres máquinas por las que la gente pregunta y que no son la misma compra.
**NVIDIA DGX Spark, $4,999.99**, 4.4 estrellas de 107 valoraciones, vendido por Micro Center en Amazon con 19 disponibles cuando miré. El listado es una placa GB10 Grace Blackwell, 128GB de memoria unificada coherente, un SSD autocifrado de 4TB, una Smart NIC ConnectX-7 y el propio DGX OS de NVIDIA. NVIDIA lo califica hasta 1 petaFLOP de FP4. Cómpralo cuando el software que te importa es CUDA: TensorRT-LLM, un bucle de entrenamiento o un contenedor que nunca se ha portado a ROCm. Para Ollama de serie con Llama y Qwen, acabas de pagar $1,500 extra por cambiar el logo.
**Framework Desktop** usa el mismo Ryzen AI Max+ 395 y ofrece una configuración de 128GB LPDDR5X-8000. Puedes reemplazar la placa base más adelante, algo que ninguno de los mini PC anteriores permite. No encontré un listado vigente en Amazon el 21 de septiembre, así que no hay enlace de afiliado. Pídelo en [frame.work/desktop](https://frame.work/desktop) y lee tú mismo el precio del configurador. Los posts de terceros discrepan en más de mil dólares, y no voy a elegir uno.
**Mac Studio M5 Max, $2,499**, preventa; Amazon dice que sale el 22 de septiembre de 2026. Los detalles del producto de ese ASIN dicen 36GB de memoria unificada. La viñeta de marketing de Apple en la misma página dice «hasta 128GB» y «hasta 614 GB/s». Ese «hasta» es otra configuración. Una máquina de 36GB aloja un 32B Q4 y no aloja un 70B Q4. El M5 Max de mucha memoria es la caja interesante para MLX, porque 614 GB/s es más del doble de los 256 GB/s de Strix Halo, y MLX es de verdad bueno. La preventa de $2,499 no es esa caja. Cero reseñas, porque aún no ha salido.
Si quieres una máquina siempre encendida más barata para modelos de 8B y 14B, deja de leer esta página y usa el [AI X1 Pro o un N150](/best-mini-pc-home-server/). Un 32B en Strix Halo es mucho dinero para 9 tok/s.
## Instala Ollama en la caja de 128GB
Instala Linux. Según el análisis de Promptquorum de agosto de 2026, el instalador de serie de Ollama en Linux usa el backend Vulkan para esta Radeon y no necesita una instalación aparte de ROCm para el camino básico. El mismo análisis dice que la compilación oficial para Windows seguía cayendo a la CPU en Strix Halo. Compra la caja para Linux, o reserva un fin de semana que quizá no ganes.
```bash
curl -fsSL https://ollama.com/install.sh | sh
ollama pull llama3.1:8b
ollama run llama3.1:8b "say hello in five words"
ollama ps
```
La descarga del 8B es una prueba de fontanería. Debería responder en un segundo o dos, y `ollama ps` debería decir GPU con un tamaño distinto de cero, no CPU. Si dice CPU, falta el cargador de Vulkan. En Ubuntu es `sudo apt install vulkan-tools mesa-vulkan-drivers`. Si sigue diciendo CPU después de eso, define `OLLAMA_VULKAN=1` en el entorno del servicio: varias configuraciones de Strix Halo solo activan la ruta de GPU con esa variable. Después descarga el modelo por el que compraste la RAM.
Si un 70B muere con un error de falta de memoria mientras `free -h` aún muestra decenas de gigabytes libres, la iGPU solo está viendo una pequeña porción reservada. La nota de ModelFit es que el ajuste de GTT del kernel es lo que expone unos 110GB de un pool de 128GB a la Radeon 8060S. El parámetro exacto ha cambiado entre versiones del kernel, así que cópialo de una nota actual de Strix Halo y no de un post de blog de la primavera pasada. Para un prompt largo, `OLLAMA_FLASH_ATTENTION=1` reduce la memoria de la caché KV. Actívala, y luego define `num_ctx` con algo que hayas medido, no 128000 a la primera.
Para una interfaz en el navegador, el [Docker compose de Ollama más Open WebUI](/es/ollama-docker-instalacion/) de este sitio es la configuración que sigo usando. Dale la GPU al contenedor. Un contenedor solo de CPU con 128GB de RAM cargará el modelo y luego te decepcionará.
Mantén la caja en Equilibrado (85W) hasta que tengas una cifra en la que confíes. El modo Rendimiento es más ruidoso, y en un modelo limitado por ancho de banda los vatios extra no son una duplicación gratis de tokens.
No. La LPDDR5X de estas cajas Strix Halo está soldada. El EVO-X2 de 64GB se queda en 64GB. Si 70B o un MoE de 120B es siquiera un quizá, paga los 128GB ahora.
No con Ollama ni llama.cpp hoy. Esos proyectos funcionan sobre la GPU. La cifra de 50 TOPS es para otros runtimes. Ignórala cuando compares estas cajas entre sí, porque todas tienen el mismo NPU.
Solo si necesitas el modelo en local y un quant más pequeño no es suficiente. Para ayuda con código y charlas cortas, un 32B en el EVO-X2 de 64GB de $2,199.99 es el mejor gasto. Para un modelo que no cabe en 32GB de VRAM, este es actualmente el ordenador pequeño menos malo.
## Lo que yo compraría
EVO-X2 de 128GB, Linux, modo de potencia Equilibrado, Open WebUI en Docker. Añadiría el MS-S1 MAX solo si hay un NAS 10GbE en el mismo escritorio. Me saltaría el GTR9 Pro a $4,349, me saltaría el Mac Studio de $2,499 para este trabajo, y miraría el DGX Spark solo cuando una herramienta solo CUDA sea el requisito real.