Los Mejores LLMs Open Source para Reemplazar Claude Opus 5.5, Fable 5.1 o GPT-6: Alternativas de IA para Codificación Accesibles 2026
Los mejores modelos de lenguaje open source que pueden reemplazar a Claude Opus 5.5, Fable 5.1 o GPT-6 para codificación a una fracción del costo: MiMo V2.6…

Actualizado Publicado 26 min de lectura
Septiembre de 2026 movió el listón propietario dos veces en tres semanas. Anthropic lanzó Claude Opus 5.5 el 22 de septiembre a $4/$20 por millón de tokens, asegurando que rinde al nivel de Claude Fable 5.1 en la mayoría del trabajo mientras cuesta un 40% menos que Opus 5. OpenAI respondió el mismo día con GPT-6 Sol y Luna, los niveles más baratos del buque insignia GPT-6 Astra que debutó el 3 de septiembre a $10/$50.
Los modelos abiertos se movieron más rápido. Solo en las últimas seis semanas llegaron GLM-5.3 y GLM-5.3-Flash de Z.ai, DeepSeek-V4.1-Flash, los pesos abiertos del núcleo de 2.4T de Qwen3.8-Max y MiMo-V2.6-Pro de Xiaomi, que ahora encabeza el índice de pesos abiertos de Artificial Analysis. Llevo semanas probándolos contra la frontera de pago en trabajo de codificación real. La brecha es menor de lo que sugiere la diferencia de precio.
Resumen de comparación de costos
Claude Opus 5.5 cuesta $4–20 por millón de tokens. Fable 5.1 y GPT-6 Astra cuestan $10–50. Los modelos abiertos de esta guía van de $0.15 a $3.00 por millón de tokens de entrada, así que según el modelo y tu tasa de aciertos de caché puedes recortar el gasto entre un 70% y un 97%.
¿Por qué considerar alternativas LLM open source?
La versión corta: el campo abierto alcanzó a los propietarios en codificación, y lo hizo mientras bajaba de precio.
- Costo: La mayoría de los modelos aquí cuestan $0.15–$3 por millón de tokens de entrada
- Pesos abiertos: Todos los modelos de la lista tienen pesos descargables, así que puedes autoalojarlos, hacer fine-tuning o fijar una versión para siempre
- Rendimiento: MiMo-V2.6-Pro, GLM-5.3 y DeepSeek-V4.1-Flash publican puntuaciones que superan a modelos fronterizos más antiguos en varias suites de codificación agéntica
- Flexibilidad: APIs de proveedores, OpenRouter o tu propio cluster de GPUs
- Ritmo: Seis lanzamientos abiertos solo desde mediados de agosto
Qué evaluar
- Codificación: Generar, depurar y refactorizar sobre un repo real
- Trabajo agéntico: Llamadas a herramientas, ejecuciones largas de múltiples pasos, no perder el hilo en el paso 200
- Longitud de contexto: Cuánto de un codebase cabe en una sola pasada
- Costo por resultado útil: No solo el precio de lista por millón de tokens
- Disponibilidad de pesos: “Abierto” va desde MIT hasta licencias con cláusulas de ingresos
El listón propietario: Opus 5.5, Fable 5.1, GPT-6
Un vistazo rápido a lo que persiguen los modelos abiertos.
Claude Opus 5.5
Lanzado el 22 de septiembre. $4 de entrada / $20 de salida por millón de tokens, contexto de 1M, salida máxima de 128K. El argumento de Anthropic es trabajo de clase Fable 5.1 con un costo de ejecución 40% menor que Opus 5, y la system card dice que iguala o supera a Fable 5.1 y Mythos 5.1 en muchas evaluaciones internas. Dos cosas que conviene saber: el pensamiento adaptativo está siempre activo (controlas la profundidad con el parámetro effort, y thinking: disabled ahora devuelve un error 400), y el uso forzado de herramientas desapareció. Si tu stack de agentes se construyó sobre Opus 5, lee las notas de migración antes de cambiar. Claude Haiku 5.5 está anunciado para las próximas semanas.
Claude Fable 5.1
Sigue siendo lo más alto de la línea de Anthropic a $10/$50. En el Artificial Analysis Intelligence Index v4.3 empata con GPT-6 Astra en 53, la puntuación más alta publicada. Este es el modelo que el campo abierto persigue de verdad en trabajo agéntico difícil, no Opus.
GPT-6 Astra, Sol y Luna
OpenAI dividió la línea en tres niveles:
- GPT-6 Astra (3 de septiembre): Buque insignia a $10/$50, entrada cacheada $1. AA Intelligence 53, empatado con Fable 5.1. Primer modelo de OpenAI calificado “Critical” en capacidad ciberseguridad bajo su Preparedness Framework, razón por la que el despliegue se limitó primero a empresas. Las peticiones de más de 272K tokens de entrada se reprecian a $20/$75.
- GPT-6 Sol (22 de septiembre): $2/$10, entrada cacheada $0.20. Inteligencia aproximada de GPT-5.6 Sol (AA 48) a mitad de precio, y 57 en el Coding Agent Index de AA, dos puntos más. DeepSWE 68.8 a máximo esfuerzo. Misma regla de reprecio a 272K.
- GPT-6 Luna (22 de septiembre): $0.10/$0.50. El único modelo propietario que queda por debajo de casi todo el campo abierto en precio de lista. Renuncias a pesos y autoalojamiento, pero en gasto puro de API compite con las opciones más baratas de abajo.
1. MiMo-V2.6-Pro: El nuevo líder de pesos abiertos
MiMo-V2.6-Pro es el buque insignia de Xiaomi del 22 de septiembre y el modelo de pesos abiertos mejor puntuado en el Intelligence Index de Artificial Analysis con 46, por delante de GLM-5.3 (45) y Kimi K3 (44). Eso lo coloca por encima de Grok 4.6 y Gemini 3.8 Flash, empatado con Grok 4.7, y a unos siete puntos de Fable 5.1 y GPT-6 Astra. Es un MoE disperso de 1.02T con 42B activos por token, licencia MIT, y nativamente omnimodal: texto, imagen, video y audio de entrada.
Dos detalles que no esperaba del laboratorio de IA de un fabricante de teléfonos: publicaron la factura del entrenamiento RL (unos $2.62M para Pro, 30 pasos en menos de seis días y alrededor de 750K trayectorias), y el precio de API se mantuvo igual que en V2.5 a $0.435/M de entrada y $0.87/M de salida.
Especificaciones técnicas
| Feature | MiMo-V2.6-Pro |
|---|---|
| Total Parameters | 1.02T (sparse MoE, 384 experts / 8 active) |
| Active Parameters | 42B |
| Context Length | 1M tokens |
| Architecture | Hybrid SWA/GA MoE + 5-layer MTP decoder |
| Multimodal | Text, image, video, audio input |
| AA Intelligence | 46 (#1 open weights) |
| DeepSWE v1.1 | 71.9 |
| Terminal-Bench 2.1 | 89.9% |
| Input Cost | $0.435/M tokens |
| Output Cost | $0.87/M tokens |
| License | MIT |
Lo que destaca
- AA Intelligence 46: La puntuación más alta entre pesos abiertos, y es el propio harness de AA el que produce el número, no la página de marketing de Xiaomi
- DeepSWE 71.9: Por encima del 70.0 de Claude Fable 5 en la misma suite, cerca del 73.0 de GPT-5.6 Sol
- Terminal-Bench 2.1 con 89.9%: La puntuación publicada más alta en esa versión del bench
- AutomationBench 53.1 y Agents’ Last Exam 31.6: Supera o empata los números publicados de Claude Opus 5 en ambos
- Entrada omnimodal: El único modelo aquí que acepta audio de forma nativa, además de imagen y video
- ~134 tok/s de salida: Rápido para un modelo de un billón de parámetros, ayudado por el decodificador especulativo MTP
- Hermanos baratos: MiMo-V2.6-Flash (310B/15B activos) a $0.14/$0.28, y una variante Pro-UltraSpeed a $4.35/$8.70 cuando quieres unas 20x de velocidad de generación
Cuándo usarlo
- Trabajo de agentes en general: La puntuación abierta más alta en el índice de AA centrado en agentes
- Sesiones de codificación largas: 1M de contexto con números fuertes en TB 2.1 y DeepSWE
- Pipelines multimodales: Capturas de pantalla, frames de video y notas de audio en un solo modelo
- Sáltalo si: necesitas una huella de autoalojamiento pequeña. 1.02T exige un nodo multi-GPU incluso cuantizado; MiMo-V2.6-Flash (310B) es la opción más realista para homelab
Bono de MiMo
Regístrate a través de go.bitdoze.com/mimo y recibe $2 de bono en crédito. Xiaomi también lanzó un cliente de escritorio MiMo y planes de membresía junto a V2.6 si prefieres una suscripción fija en lugar de facturación por token.
2. GLM-5.3: El burro de carga de la codificación abierta
GLM-5.3 se lanzó el 14 de agosto a través del GLM Coding Plan, con los pesos abiertos llegando el 28 de agosto. Misma base 744B-A40B que GLM-5.2; toda la mejora viene del post-entrenamiento. Los números muestran hasta dónde llega eso: Terminal-Bench 3.0 saltó de 4.6 a 28.3, DeepSWE de 46.2 a 66.9, y Z.ai afirma una mejora del 50% en su bench interno de código. Z.ai lo llama el modelo de codificación de pesos abiertos más capaz, y mantiene AA Intelligence 45, segundo entre los modelos abiertos.
Una salvedad: la ronda de post-entrenamiento de GLM-5.3 también produjo un gran salto en capacidad ciberseguridad. Z.ai es transparente al respecto (CyberGym 84.5, estado del arte; los benchmarks de explotación se duplicaron con creces frente a 5.2). Útil para investigación de seguridad, y una razón para mantener los permisos de los agentes ajustados de todos modos.
Especificaciones técnicas
| Feature | GLM-5.3 |
|---|---|
| Parameters | 744B total / 40B active |
| Context Length | 1M tokens |
| Max Output | 128K tokens |
| Modality | Text only |
| Terminal-Bench 2.1 | 88.2% |
| Terminal-Bench 3.0 | 28.3 (SOTA abierto) |
| DeepSWE v1.1 | 66.9 |
| Input Cost | $1.40/M tokens ($0.26 cached) |
| Output Cost | $4.40/M tokens |
| License | GLM-5.3 License (estilo MIT, con cláusula MaaS de $10B de ingresos) |
Fortalezas clave
- Terminal-Bench 3.0 con 28.3: SOTA abierto, desde el 4.6 de GLM-5.2; Fable 5 consigue 33.7 y GPT-5.6 Sol 34.6, así que está cerca de la frontera en el bench más difícil
- FrontierSWE 78.1: La mejor puntuación abierta de esa suite en la tabla de lanzamiento
- 1M de contexto, 128K de salida: El mismo sobre que los buques insignia propietarios
- Tres protocolos de API: OpenAI Chat Completions, OpenAI Responses y Anthropic Messages, así que las herramientas estilo Claude Code funcionan directamente
- Mismo precio que 5.2: $1.40/$4.40 sin cambios pese al salto de capacidad
GLM Coding Plans
Los GLM Coding Plans ahora funcionan con una cuota basada en puntos. Las llamadas en horario valle, incluido todo el día en fin de semana, consumen la mitad de los puntos estándar. GLM-5.3 está disponible en todos los niveles del plan.
Mejores casos de uso
- Agente de codificación de uso diario: El perfil de codificación abierto más completo
- Trabajo de terminal de largo horizonte: Las ganancias en TB 3.0 sugieren que aguanta donde otros modelos se desarman
- Stacks estilo Claude Code: Endpoint nativo de Anthropic Messages
- Autoalojamiento a escala: Pesos FP8 y BF16 en Hugging Face y ModelScope, pero 744B es territorio de cluster
3. DeepSeek-V4.1-Flash: El rey de la eficiencia
DeepSeek-V4.1-Flash se publicó el 10 de septiembre bajo MIT, y es la arquitectura más interesante de esta lista. Usa un diseño Causal Encoder-Decoder: 552B de parámetros totales, pero solo 8B activos al leer tu entrada y 16B al generar salida. Combinado con el cacheo KV en FP4, su caché KV de trabajo es de unos 890 bytes por token, aproximadamente una cuarta parte del de su predecesor. En términos llanos: está construido para que servir bucles de agentes de un millón de tokens salga barato.
Los números reportados por el proveedor son agresivos: Terminal-Bench 2.1 con 90.6% (la puntuación más alta que he visto publicada en esa suite) y DeepSWE 74.2, por encima del 70.0 de Fable 5 y el 73.0 de GPT-5.6 Sol. Trátalos como ejecuciones propias de DeepSeek hasta que llegue más verificación de terceros. Lo curioso: Artificial Analysis le da 39 en el Intelligence Index, muy por debajo de sus resultados de codificación, porque ese índice premia la amplitud y V4.1-Flash es un especialista.
Especificaciones técnicas
| Feature | DeepSeek-V4.1-Flash |
|---|---|
| Parameters | 552B MoE |
| Active Parameters | 8B on input / 16B on output |
| Context Length | 1M tokens |
| Max Output | 384K tokens |
| Modality | Text + image input |
| Terminal-Bench 2.1 | 90.6% |
| DeepSWE v1.1 | 74.2 |
| Terminal-Bench 3.0 / 4.0 | 30.0 / 31.2 |
| Input Cost | $0.30/M peak, $0.15/M off-peak |
| Output Cost | $1.20/M peak, $0.60/M off-peak |
| Cache Hit | $0.006/M peak |
| License | MIT |
Lo que hace bien
- Prefill con 8B activos: Las cargas de agentes intensivas en entrada (volcados de repos, salidas de herramientas, prompts largos) cuestan una fracción de las lecturas densas
- 90.6% Terminal-Bench 2.1 y 74.2 DeepSWE: Ejecutados por el proveedor, pero por delante de las puntuaciones publicadas de Fable 5 y GPT-5.6 Sol
- Mitad de precio en horario valle: 01:00–04:00 y 06:00–10:00 UTC entre semana son las horas pico; todo lo demás se factura al 50%. Programa tus evals y ejecuciones nocturnas en consecuencia
- Salida máxima de 384K: El mayor presupuesto de salida de la lista, útil para generar archivos largos
- Pesos MIT desde el día uno: Lanzamiento abierto de verdad, con un informe técnico de 51 páginas
Cuándo usarlo
- Agentes siempre activos con presupuesto: $0.30/$1.20 en pico, la mitad en valle
- Codificación de terminal y a nivel de repo: Donde su perfil de benchmarks es más fuerte
- Experimentos de autoalojamiento: Pesos MIT más la historia de serving más eficiente en caché de la lista
- Sáltalo si: necesitas trabajo amplio de conocimiento general; su índice AA muestra las contrapartidas de la especialización. Un V4.1-Pro viene en camino para eso.
4. GLM-5.3-Flash: El monstruo del precio
GLM-5.3-Flash se lanzó el 26 de agosto bajo MIT, y reorganizó en silencio el nivel económico. 320B totales, 18B activos, con una pila de atención híbrida que intercala 34 capas de atención lineal KDA con 11 capas de atención dispersa en un patrón 3:1. Eso recorta el cómputo de atención unas 3x y la caché KV unas 4.4x frente a GLM-5.3. También es el primer GLM-5 nativamente multimodal, con entrada de imagen y video.
La clave es el precio: $0.15/M de entrada y $0.50/M de salida, con $0.03 en caché. Puntúa 84.3% en Terminal-Bench 2.1, 63.4 en DeepSWE, y mantiene AA Intelligence 42, cuarto entre los modelos abiertos. Dato curioso: antes del lanzamiento circuló por OpenRouter y OpenCode como el modelo anónimo “Ox Alpha” que la gente intentaba identificar.
Especificaciones técnicas
| Feature | GLM-5.3-Flash |
|---|---|
| Parameters | 320B total / 18B active |
| Context Length | 1M tokens |
| Architecture | Hybrid KDA linear + sparse attention |
| Multimodal | Text, image, video input |
| AA Intelligence | 42 |
| Terminal-Bench 2.1 | 84.3% |
| DeepSWE v1.1 | 63.4 |
| Input Cost | $0.15/M tokens ($0.03 cached) |
| Output Cost | $0.50/M tokens |
| License | MIT |
Lo que hace bien
- Precio $0.15/$0.50: El modelo más barato de la lista a precio de lista, y supera a GLM-5.2 (que costaba ~9x más) en cada bench reportado
- AA Intelligence 42: A cuatro puntos del buque insignia GLM-5.3
- Multimodalidad nativa: Entrada de imagen y video a precios económicos
- Perfil 320B/18B: El objetivo de autoalojamiento más práctico entre los grandes lanzamientos; los pesos FP8 caben en un solo nodo multi-GPU
- GDPval-AA 1773 Elo: Puntuación sólida de trabajo real para tareas de oficina
Mejores casos de uso
- Modelo por defecto para todo lo barato: Reemplaza a MiniMax M3 como mi elección económica; M3 sigue teniendo su lugar vía el Token Plan si quieres una suscripción fija
- Stack de codificación autoalojado: Licencia MIT, soporte vLLM/SGLang, un nodo en lugar de un cluster
- Multimodal con presupuesto: De captura de pantalla a código y comprensión de video sin pagar precios de K3
- Bucles de agentes de alta frecuencia: Los aciertos de caché a $0.03/M hacen las sesiones calientes casi gratis
5. Kimi K3: Siguen siendo los pesos abiertos más grandes
Kimi K3 ya no lidera el índice AA de pesos abiertos, pero con 2.8T de parámetros sigue siendo el lanzamiento abierto más grande, y sus números de codificación se mantienen: Terminal-Bench 2.1 con 88.3%, DeepSWE 67.5, SWE-Marathon 42.0, FrontierSWE 81.2 y BrowseComp 91.2 para agentes de investigación web. AA Intelligence 44 lo coloca tercero entre los modelos abiertos. Desde el 18 de septiembre también está disponible de forma general en Amazon Bedrock, lo que importa si tu organización quiere la historia de pesos abiertos dentro de un perímetro de seguridad AWS con caché de prompts.
La salvedad de precios de la versión original de esta guía sigue vigente: $3/M de entrada y $15/M de salida es dinero casi de frontera. Los aciertos de caché a $0.30/M son lo que lo mantiene cuerdo en bucles de codificación calientes. Si tu tasa de aciertos de caché es mala, MiMo-V2.6-Pro hace trabajo comparable por una séptima parte del precio de salida.
Especificaciones técnicas
| Feature | Specification |
|---|---|
| Total Parameters | 2.8T (MoE, 16 of 896 experts) |
| Active Parameters | ~104B |
| Context Length | 1M tokens |
| Architecture | MoE + Kimi Delta Attention |
| Multimodal | Text, image, video input |
| AA Intelligence | 44 (#3 open weights) |
| Terminal-Bench 2.1 | 88.3% |
| BrowseComp | 91.2 |
| Input Cost | $0.30/M cache-hit / $3.00/M fresh |
| Output Cost | $15.00/M |
| License | Kimi K3 License (open weights) |
Lo que destaca
- 2.8T de pesos abiertos: Nada más descargable llega a este tamaño; autoalojarlo significa un cluster de verdad, no un mini PC
- FrontierSWE 81.2: La mejor puntuación de esa suite en su tabla de lanzamiento
- BrowseComp 91.2: Sigue siendo la elección para agentes de investigación web
- GA en Bedrock: Primer modelo de pesos abiertos en Bedrock con caché de prompts explícita, una vía enterprise realmente útil
- 1M de contexto + multimodal: Imagen y video en las mismas sesiones largas
Cuándo usarlo
- Codificación dura y maratones de agentes: Liderazgo en FrontierSWE y SWE-Marathon entre modelos abiertos
- Agentes de investigación intensivos en web: BrowseComp 91.2
- Tiendas AWS: GA en Bedrock con cacheo desde el 18 de septiembre
- Sáltalo si te preocupa el precio: $15/M de salida es lo más alto de la lista por un amplio margen
6. Qwen3.8-Max y los pesos abiertos de 2.4T
Alibaba está manejando Qwen 3.8 como dos productos con un solo nombre. Qwen3.8-Max es la API alojada a $2/$6 por millón de tokens, activa desde el 3 de agosto y refrescada el 2 de septiembre como Qwen3.8-Max-0902. Ese snapshot debutó en el #1 del leaderboard Code Arena WebDev de Arena con 1,691 puntos, superando a Claude Opus 5 por 3 puntos y a Kimi K3 por 17. Sus puntuaciones en Terminal-Bench 3.0 y ProgramBench se duplicaron con creces frente a la build de lanzamiento. Si tu trabajo es frontend y “vibe coding”, esta es la opción más fuerte del ecosistema abierto ahora mismo.
La mitad descargable es Qwen3.8-2.4T-A95B, lanzado el 12 de agosto: 2.4T de parámetros, 95B activos, atención híbrida lineal más completa, 262K de contexto nativo extensible a 1M, bajo una licencia Qwen personalizada. Los quants comunitarios MXFP4/NVFP4 lo comprimen a unos 1.2TB, lo que cabe en un solo nodo B300 de 8 GPUs. Una pega: el post-entrenamiento 0902 de septiembre es solo API por ahora, así que los pesos van por detrás del modelo alojado.
Especificaciones técnicas
| Feature | Qwen3.8-Max / Qwen3.8-2.4T-A95B |
|---|---|
| Parameters | 2.4T total / 95B active |
| Context Length | 1M API / 262K native on weights |
| Code Arena WebDev | 1691 (#1, 0902 snapshot) |
| Terminal-Bench 2.1 | 86.6% vendor / 88.8% independent (AA) |
| Input Cost | $2.00/M tokens ($0.25 cache read) |
| Output Cost | $6.00/M tokens |
| License | Custom Qwen license (open weights) |
Lo que ofrece
- #1 en Code Arena WebDev: Primer modelo chino en encabezar ese leaderboard; aviso justo, mide sobre todo generación de UI de una sola pasada
- Pesos abiertos a escala Max: Primer lanzamiento de clase Qwen-Max con pesos descargables
- Precio de API $2/$6: Aproximadamente una quinta parte de la tarifa de salida de Fable 5.1
- API con contexto de 1M: Con cacheo implícito de prefijos a $0.25/M
- Hermanos menores: Qwen3.8-27B (AA 52 en xhigh, impresionante para su tamaño) y Qwen3.8-Flash-Next si 2.4T es demasiado hierro
Cuándo usarlo
- Frontend y diseño-a-código: El liderazgo en la arena WebDev es todo el argumento
- Comodidad de API más una salida a pesos: Empieza en QwenCloud, conserva la opción de autoalojar el 2.4T
- Autoalojamiento de clase frontera: Si tienes el nodo para ello, este es el segundo modelo abierto más grande después de K3
- Sáltalo si: necesitas las mejoras de septiembre on-prem hoy; el checkpoint 0902 es solo alojado por ahora
Comparación lado a lado
Números a 24 de septiembre de 2026. Los huecos significan no publicado o no comparable en esa suite exacta. Algunas cifras son reportadas por el proveedor; toma los números de fuente única con cautela.
| Benchmark | MiMo V2.6 Pro | GLM-5.3 | DS V4.1 Flash | GLM-5.3 Flash | Kimi K3 | Qwen3.8-Max | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|---|---|---|---|---|---|
| AA Intelligence | 46 | 45 | 39 | 42 | 44 | 40* | — | 48 | 53 |
| Terminal-Bench 2.1 | 89.9% | 88.2% | 90.6% | 84.3% | 88.3% | 86.6% | — | — | — |
| Terminal-Bench 4.0 | 34.9% | — | 31.2% | — | — | — | — | 43% | — |
| DeepSWE v1.1 | 71.9 | 66.9 | 74.2 | 63.4 | 67.5 | 56.6 | 74.0† | 68.8 | — |
| AutomationBench | 53.1 | 48.2 | 54.8 | 48.8 | 30.8 | — | 50.3† | 33.2 | — |
| Context | 1M | 1M | 1M | 1M | 1M | 1M API / 262K wts | 1M | 1.05M | 1.05M |
| Multimodal | Img+vid+audio | No | Image | Img+video | Img+video | API yes / wts no | Yes | Yes | Yes |
| Open Weights | MIT | GLM lic. | MIT | MIT | Kimi lic. | Custom | No | No | No |
| Input $/M | $0.44 | $1.40 | $0.15–0.30 | $0.15 | $0.30–3.00 | $2.00 | $4.00 | $2.00 | $10.00 |
| Output $/M | $0.87 | $4.40 | $0.60–1.20 | $0.50 | $15.00 | $6.00 | $20.00 | $10.00 | $50.00 |
*La puntuación AA de Qwen corresponde a los pesos abiertos 2.4T-A95B. †Cifras de Opus 5 donde Opus 5.5 no tiene ejecución publicada; Anthropic sitúa a 5.5 aproximadamente al nivel de Fable 5.1, y Fable 5.1 puntúa 53 en el índice AA.
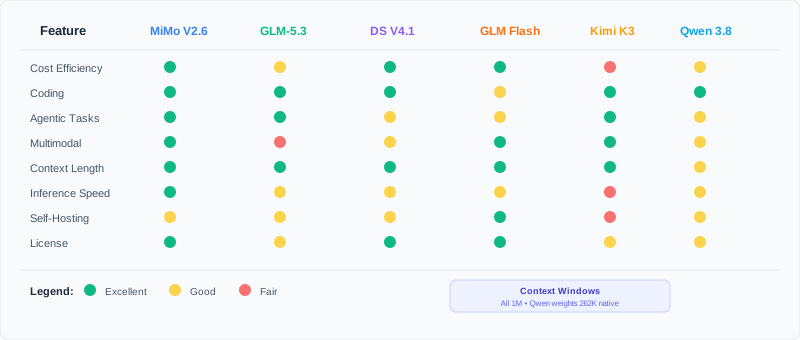
Matriz de comparación de features
Empezando
Paso 1: Elige el acceso
- OpenRouter: Una clave, todos los modelos de la lista, la forma más rápida de comparar
- APIs directas de proveedor: Mejores límites de tasa y precios de plan (Z.ai, DeepSeek, Xiaomi MiMo, Qwen, Kimi)
- Autoalojamiento: GLM-5.3-Flash (320B) es la opción realista de un solo nodo; K3 y Qwen 2.4T piden un cluster
- Herramientas de agentes: OpenCode, endpoints compatibles con Claude Code, Hermes, configuraciones de Codex con cualquier modelo
Paso 2: Entorno (ejemplo con OpenRouter)
# Install OpenAI SDK
pip install openai

# Set environment variables
export OPENROUTER_API_KEY="tu_api_key_aqui"
export OPENROUTER_BASE_URL="https://openrouter.ai/api/v1"
Paso 3: Llamada básica
import openai

client = openai.OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key="tu_openrouter_api_key"
)

# GLM-5.3 para codificación agéntica del día a día
response = client.chat.completions.create(
    model="z-ai/glm-5.3",
    messages=[
        {"role": "system", "content": "You are a helpful coding assistant."},
        {"role": "user", "content": "Create a Python web scraper for product prices"}
    ]
)

print(response.choices[0].message.content)
Paso 4: Ajusta el contexto al trabajo
Longitud de contexto
Todos los modelos aquí anuncian una ventana de 1M de tokens, pero el contexto largo no es gratis: los proveedores cobran más al superar umbrales (GPT-6 se reprecia por encima de 272K de entrada), y los pesos abiertos de Qwen solo hacen 262K de forma nativa antes de la extensión. Para opciones baratas de contexto largo, mira nuestra guía de mejores modelos baratos para Hermes Agent.
Desglose de costos
Costo mensual ilustrativo con 10M de tokens de entrada + 10M de salida, a tarifas de lista de API. Las facturas reales se mueven con aciertos de caché, planes y horarios valle. Opus 5.5 es la línea base esta vez.
Comparación de costo mensual (10M entrada + 10M salida)
| Model | Input | Output | Total | vs Opus 5.5 |
|---|---|---|---|---|
| GPT-6 Astra | $100 | $500 | $600 | — |
| Claude Fable 5.1 | $100 | $500 | $600 | — |
| Claude Opus 5.5 | $40 | $200 | $240 | Base |
| GPT-6 Sol | $20 | $100 | $120 | ~50% menos |
| Kimi K3 (entrada fresca) | $30 | $150 | $180 | ~25% menos |
| Kimi K3 (entrada cacheada) | $3 | $150 | $153 | ~36% menos |
| Qwen3.8-Max | $20 | $60 | $80 | ~67% menos |
| GLM-5.3 | $14 | $44 | $58 | ~76% menos |
| DeepSeek V4.1 Flash (pico) | $3 | $12 | $15 | ~94% menos |
| MiniMax M3 | $3 | $12 | $15 | ~94% menos |
| MiMo V2.6 Pro | $4.35 | $8.70 | $13.05 | ~95% menos |
| GLM-5.3 Flash | $1.50 | $5 | $6.50 | ~97% menos |
| DeepSeek V4.1 Flash (valle) | $1.50 | $6 | $7.50 | ~97% menos |
Dos notas al pie. GPT-6 Luna a $0.10/$0.50 queda por debajo de casi todo lo de aquí ($6 con esta cuenta), así que el precio puro por token ya no es exclusivo del open source. Lo que Luna no te da son pesos, autoalojamiento ni un segundo proveedor cuando la API tiene problemas. Y los $15/M de salida de Kimi K3 significan que su fama de “barato” solo se sostiene cuando tu tasa de aciertos de caché de entrada se mantiene alta.
Consejos y errores comunes
Lo que funciona
- Empareja modelo con tarea: GLM-5.3-Flash o DeepSeek para volumen, MiMo Pro o GLM-5.3 para ejecuciones de agentes difíciles, K3 para agentes de investigación
- Usa las ventanas valle: DeepSeek reduce a la mitad los precios fuera de sus dos ventanas pico diarias; el GLM Coding Plan reduce a la mitad los puntos en valle y los fines de semana
- Prompt por modelo: Cada familia sigue teniendo sus propias manías de instrucciones
- Mide en tu dominio: Los benches de proveedores son marketing con sección de metodología; ejecuta tus propias evaluaciones
- Mantén un respaldo: Los proveedores fallan; OpenRouter convierte el cambio en una línea de configuración
Qué evitar
- Enrutar cada tarea al modelo más caro por defecto
- Confiar en benchmarks reportados por el proveedor sin ejecuciones independientes (los números de DeepSeek V4.1-Flash son en su mayoría autorreportados por ahora)
- Dejar correr agentes sin delimitar permisos, sobre todo con la velocidad a la que crece la capacidad ciberseguridad en estos lanzamientos
- Ignorar la letra pequeña de las licencias: MIT es limpia, GLM-5.3 tiene una cláusula MaaS de $10B, Qwen y Kimi usan términos personalizados
Lo que viene
- DeepSeek-V4.1-Pro: El buque insignia de la familia; V4.1-Flash ya supera a V4-Pro en la mayoría de las suites, así que el Pro debería mover la frontera abierta otra vez
- Claude Haiku 5.5: Anunciado para las próximas semanas; si aterriza cerca de la calidad de Opus 5.5 a precio de Haiku, la cuenta económica cambia de nuevo
- Pesos Qwen3.8 refrescados: El post-entrenamiento 0902 es solo API hoy; un checkpoint actualizado importaría a quienes autoalojan
- Tencent Hy4: Preview de 770B en Apache-2.0 del 28 de agosto, ya por delante de MiniMax M3 en la mayoría de las suites; vale la pena vigilarlo al salir de preview
- Ecosistema MiMo-V2.6: La variante Flash a $0.14/$0.28 y la receta abierta de entrenamiento RL pueden acabar importando más que el buque insignia
¿Cuál deberías elegir?
MiMo-V2.6-Pro si quieres:
- La puntuación de pesos abiertos más alta (AA 46) con pesos MIT
- Números agénticos fuertes (AutomationBench 53.1, TB 2.1 89.9%)
- Texto + imagen + video + audio en un solo modelo
- Precio $0.44/$0.87, ~134 tok/s
GLM-5.3 si necesitas:
- El perfil de codificación abierto más fuerte (TB 3.0 28.3, FrontierSWE 78.1)
- Un conductor diario probado con opciones de suscripción Coding Plan
- Endpoint compatible con Anthropic para herramientas estilo Claude Code
- Precios predecibles de $1.40/$4.40
DeepSeek V4.1 Flash si quieres:
- El mejor Terminal-Bench 2.1 publicado (90.6%) y DeepSWE (74.2)
- Pesos MIT y el serving de agentes serio más barato
- Precios valle que reducen a la mitad una factura ya baja
- Presupuesto de salida de 384K para generaciones largas
GLM-5.3-Flash si quieres:
- Precio de lista $0.15/$0.50 con pesos MIT
- Entrada nativa de imagen + video
- Un modelo de 320B que cabe en un nodo
- 84.3% en TB 2.1, cuatro puntos AA por detrás de su hermano buque insignia
Kimi K3 si quieres:
- Los pesos abiertos más grandes (2.8T)
- Agentes de investigación con BrowseComp 91.2
- Despliegue en AWS Bedrock con caché de prompts
- Puedes vivir con $15/M de salida apoyándote en los aciertos de caché
Qwen3.8-Max si te importa:
- #1 en Code Arena WebDev para trabajo de frontend
- Precio de API $2/$6 con contexto de 1M
- Una vía de pesos abiertos de 2.4T cuando estés listo para autoalojar
Mi ranking para trabajo de agentes de codificación ahora mismo: GLM-5.3 como opción por defecto, MiMo-V2.6-Pro cuando la tarea es larga o multimodal, GLM-5.3-Flash para volumen, DeepSeek V4.1-Flash para bucles intensivos de terminal, y Kimi K3 o Qwen3.8-Max cuando sus fortalezas específicas (investigación, frontend) encajan con el trabajo. Los seis quedan por debajo de Opus 5.5, y la mayoría lo hace por un margen abismal.
¿Listo para empezar?
Los seis modelos son accesibles a través de sus proveedores y la mayoría están en OpenRouter. Si usas la app de Codex, nuestra guía de Codex con cualquier modelo muestra cómo conectar GLM, MiniMax y MiMo con una configuración corta. Para agentes de codificación en un VPS barato, mira la guía de configuración de OpenCode y la guía del agente de codificación Pi. Precios completos y benches centrados en Hermes están en mejores modelos baratos para Hermes Agent, y el mapa más amplio de herramientas está en top repos de IA en GitHub.