Tutorial de Mirage: Dale a tu Agente de IA un Sistema de Archivos Universal en 10 Minutos
Monta S3, Google Drive, Slack, GitHub y más como un único sistema de archivos que tus agentes de IA pueden recorrer con comandos bash simples. Sin SDKs por servicio.

18 min de lectura
Si has construido algo con agentes de IA que se comunique con más de un servicio, ya conoces el problema. Tu agente necesita leer un archivo de S3, revisar un hilo de Slack, extraer un Google Doc y consultar un repo de GitHub. Cada uno requiere su propio SDK, su propio flujo de autenticación, su propio conjunto de llamadas a métodos. Tu prompt engineering se convierte en un malabarismo de instrucciones de API.
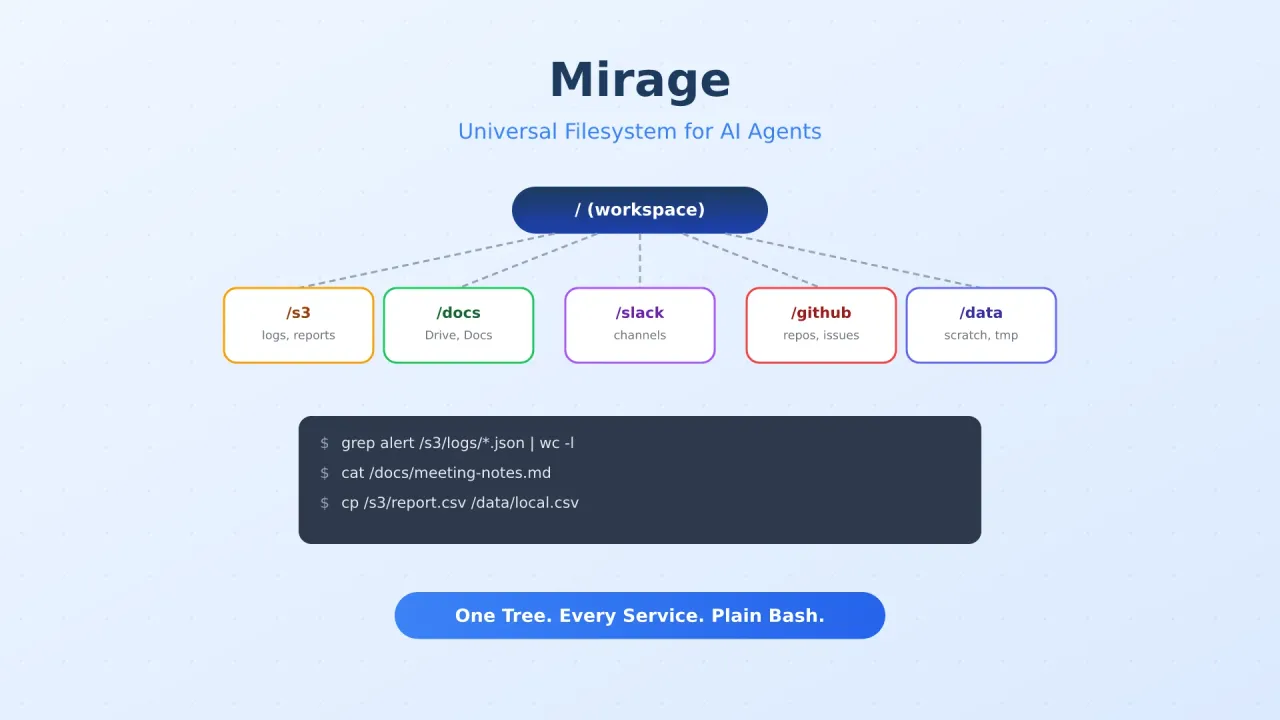
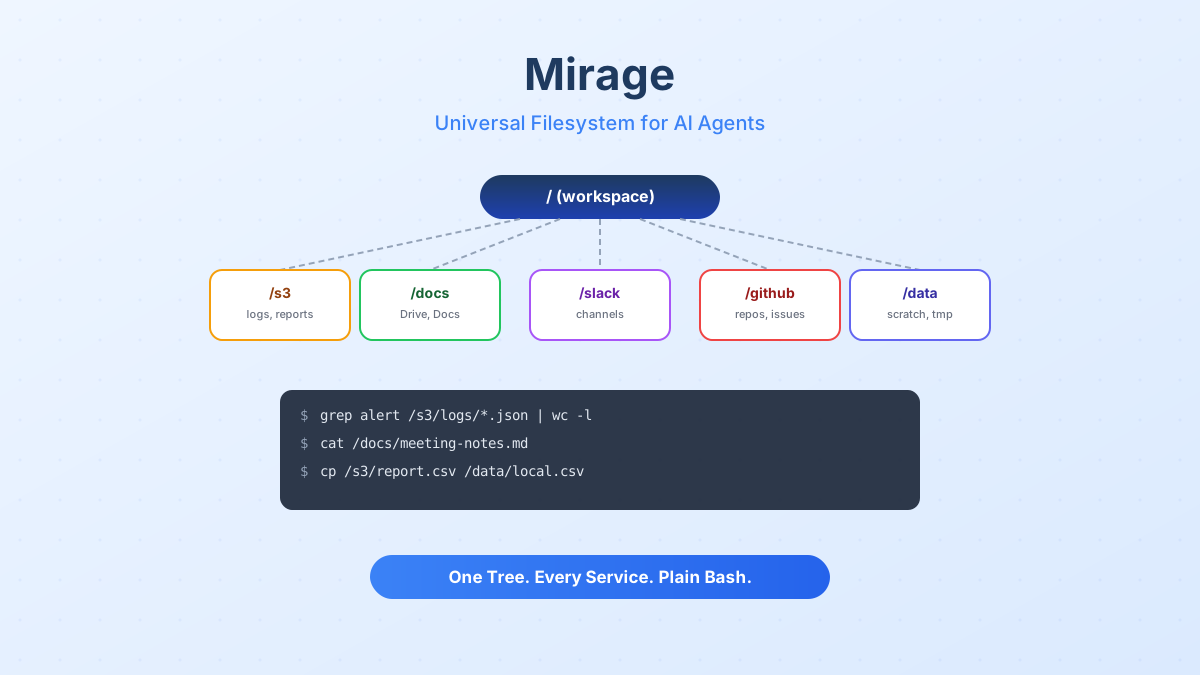
Mirage adopta un enfoque diferente. Monta todos esos servicios como ramas de un único árbol de sistema de archivos virtual — S3, Google Drive, Slack, GitHub, Redis, Gmail, lo que necesites. Tu agente los recorre con ls, cat, grep y pipes.
La razón por la que esto funciona bien es simple: todos los LLM importantes ya conocen bash. El sistema de archivos de Unix es probablemente la interfaz para la que los LLM tienen más datos de entrenamiento. Mirage se apoya en ese conocimiento existente en lugar de pedir a los modelos que aprendan otra superficie de API más.
Esta guía te lleva por la configuración de Mirage, el montaje de tus primeros backends y su integración en un framework de agentes. Tendrás una configuración funcional en unos 10 minutos.
Qué hace Mirage realmente
Mirage te da un objeto Workspace. Montas servicios en rutas de ese workspace y luego ejecutas comandos de shell contra el árbol combinado.
from mirage import Workspace
from mirage.resource.s3 import S3Config, S3Resource
from mirage.resource.slack import SlackConfig, SlackResource
from mirage.resource.ram import RAMResource

ws = Workspace({
    "/data":  RAMResource(),
    "/s3":    S3Resource(S3Config(bucket="my-bucket")),
    "/slack": SlackResource(SlackConfig()),
})

# These commands hit different backends, but the agent sees one tree
await ws.execute("ls /s3/logs/")
await ws.execute("grep error /slack/engineering/*.json | wc -l")
await ws.execute("cp /s3/report.csv /data/local.csv")
El shell no es un /bin/bash real — es un parser tree-sitter con un ejecutor personalizado que dirige los comandos a handlers por montaje. Los pipes, globs, &&, || y la mayoría de los verbos Unix comunes funcionan. El agente nunca toca tu sistema de archivos del anfitrión ni genera subprocesos.
Backends soportados
Mirage cubre una buena variedad de servicios de serie:
| Categoría | Backends |
|---|---|
| Almacenamiento | S3, R2, OCI, Supabase, GCS, RAM, Disk |
| Gmail, Google Drive, Google Docs, Sheets, Slides | |
| Colaboración | GitHub, Linear, Notion, Trello, Slack, Discord, Telegram, Email |
| Bases de datos | Redis, MongoDB, Postgres |
| Remoto | SSH |
Cada uno se monta en la ruta que elijas. El agente no necesita saber con qué backend está hablando — solo lee y escribe archivos.
Mirage vs servidores MCP por servicio
¿Cómo se compara esto con MCP?
| Aspecto | Mirage | Servidores MCP por servicio |
|---|---|---|
| Configuración | Un workspace, configuración de montaje por servicio | Un servidor por servicio |
| Vocabulario del agente | Bash estándar (ls, cat, grep, pipes) |
Esquemas de herramientas personalizados por servidor |
| Pipelines entre servicios | Nativos (pipes entre montajes) | Orquestación manual en código |
| Caché | Caché integrada de dos capas (índice + archivo) | Varía según el servidor |
| Portabilidad | Snapshots y clonación de workspaces | Estado disperso entre servidores |
| Soporte de frameworks | OpenAI Agents SDK, Vercel AI SDK, LangChain, Pydantic AI | Depende del cliente MCP |
Los servidores MCP siguen siendo útiles para servicios que necesitan llamadas a herramientas estructuradas (como “crear un evento de calendario”). Mirage funciona mejor cuando el patrón de interacción es leer/escribir/buscar, que cubre una gran parte de lo que los agentes hacen realmente.
Requisitos previos
- Python 3.12+ o Node.js 20+
- macOS o Linux
- Credenciales para al menos un backend (bucket de S3, token de Slack, etc.)
Paso 1: Instalar Mirage
Python
uv add mirage-aiEsto instala tanto la librería mirage como el binario CLI mirage.
TypeScript (Node)
npm install @struktoai/mirage-nodePara runtimes de navegador o edge, usa @struktoai/mirage-browser en su lugar. El paquete @struktoai/mirage-core proporciona primitivas agnósticas de runtime si necesitas un control más detallado.
Solo CLI
curl -fsSL https://strukto.ai/mirage/install.sh | shO vía npm/npx:
npm install -g @struktoai/mirage-cli
# or
npx @struktoai/mirage-cli
# or
uvx mirage-ai
No se requiere FUSE
Mirage ejecuta el workspace en el propio proceso. No necesitas soporte FUSE a menos que quieras que las herramientas del anfitrión (editores, language servers, rg) también vean el sistema de archivos montado.
Paso 2: Crear un workspace y montar servicios
El workspace es el objeto central. Lo defines con un diccionario que mapea rutas de montaje a instancias de recursos.
Python
from mirage import Workspace
from mirage.resource.ram import RAMResource
from mirage.resource.s3 import S3Config, S3Resource
from mirage.resource.slack import SlackConfig, SlackResource
from mirage.resource.gdocs import GDocsConfig, GDocsResource
from mirage.resource.github import GitHubConfig, GitHubResource

ws = Workspace({
    "/data":   RAMResource(),
    "/s3":     S3Resource(S3Config(bucket="my-logs-bucket")),
    "/slack":  SlackResource(SlackConfig()),
    "/docs":   GDocsResource(GDocsConfig()),
    "/github": GitHubResource(GitHubConfig()),
})
TypeScript
import {
  Workspace,
  RAMResource,
  S3Resource,
  SlackResource,
  GDocsResource,
  GitHubResource,
} from '@struktoai/mirage-node'

const ws = new Workspace({
  '/data':   new RAMResource(),
  '/s3':     new S3Resource({ bucket: 'my-logs-bucket' }),
  '/slack':  new SlackResource({}),
  '/docs':   new GDocsResource({}),
  '/github': new GitHubResource({}),
})
Cada recurso necesita sus propias credenciales. Mirage las lee de variables de entorno o de objetos de configuración explícitos. Consulta la matriz de recursos para los detalles de configuración por backend.
Paso 3: Ejecutar comandos contra el árbol combinado
Una vez configurado el workspace, cada comando pasa por execute():
# List files in S3
await ws.execute("ls /s3/logs/2026/05/")

# Search across Slack messages
await ws.execute("grep 'incident' /slack/incidents/*.json")

# Pipe data between backends
await ws.execute("cat /s3/report.csv | head -20 > /data/preview.txt")

# Read a Google Doc
await ws.execute("cat /docs/meeting-notes.md")

# Search GitHub repo contents
await ws.execute("grep -r 'TODO' /github/my-repo/src/")
El agente usa los mismos comandos que usaría en un sistema de archivos local. No hay vocabulario nuevo que aprender ni llamadas a métodos de SDK que memorizar.
Comandos personalizados
Puedes registrar tus propios comandos que funcionan en todos los montajes:
# Register a summarize command available everywhere
ws.command('summarize', summarize_handler)

# Override a command for a specific resource + filetype
# cat on a Parquet file in /s3 renders rows as JSON
ws.command('cat', {'resource': 's3', 'filetype': 'parquet'}, parquet_cat_handler)

await ws.execute('summarize /github/my-repo/README.md')
await ws.execute('cat /s3/events/2026-05-06.parquet | jq .user')
Paso 4: Integrarlo en tu framework de agentes
Mirage incluye adaptadores para los principales frameworks de agentes. Así es como se conecta.
OpenAI Agents SDK
from agents import Runner
from agents.run import RunConfig
from agents.sandbox import SandboxAgent, SandboxRunConfig
from mirage.agents.openai_agents import MirageSandboxClient

client = MirageSandboxClient(ws)
agent = SandboxAgent(
    name="Filesystem Agent",
    model="gpt-4.1",
    instructions=ws.file_prompt,
)

result = await Runner.run(
    agent,
    "Find all error logs from last week in /s3 and summarize them.",
    run_config=RunConfig(sandbox=SandboxRunConfig(client=client)),
)
La propiedad ws.file_prompt genera un prompt de sistema que describe al modelo la estructura del sistema de archivos montado. El agente ejecuta comandos bash contra tus montajes a través del cliente sandbox.
Vercel AI SDK (TypeScript)
import { generateText } from 'ai'
import { openai } from '@ai-sdk/openai'
import { mirageTools } from '@struktoai/mirage-agents/vercel'
import { buildSystemPrompt } from '@struktoai/mirage-agents/openai'

const { text } = await generateText({
  model: openai('gpt-4.1'),
  system: buildSystemPrompt({
    mountInfo: { '/s3': 'S3 bucket', '/slack': 'Slack messages' }
  }),
  prompt: "Read /s3/data/report.pdf, then describe what's in it.",
  tools: mirageTools(ws),
})
También hay adaptadores para LangChain, Pydantic AI, CAMEL y OpenHands. El patrón es el mismo: pasas el workspace y recibes herramientas.
CLI con Claude Code o Codex
El CLI de Mirage se conecta directamente a agentes de codificación. Funciona con Hermes Agent, OpenCode, Pi Agent y cualquier herramienta que exponga una interfaz de shell.
# Create a workspace config
mirage workspace create ws.yaml --id my-agent

# Run commands
mirage execute --workspace_id my-agent --command "grep alert /s3/logs/*.json"

# Snapshot for reuse
mirage workspace snapshot my-agent my-agent.tar
Paso 5: Configurar la caché
Cada workspace incluye una caché de dos capas para que las lecturas repetidas no lleguen a la red:
- La caché de índice almacena los listados de directorios y los metadatos. El primer
lsllega a la API; los siguientes se sirven desde la caché hasta que el TTL expira. - La caché de archivos almacena los bytes de los objetos. El primer
catse transmite desde el origen; las lecturas posteriores vienen de la caché.
Por defecto, Mirage usa una caché RAM en el propio proceso (caché de archivos de 512 MB, TTL de índice de 10 minutos). Para configuraciones de producción con múltiples workers o procesos, cambia a Redis:
import { RedisFileCacheStore, RedisIndexCacheStore, Workspace } from 'mirage/node'

const ws = new Workspace(
  { '/s3': new S3Resource({ bucket: 'my-bucket' }) },
  {
    cache: new RedisFileCacheStore({
      url: 'redis://localhost:6379/0',
      limit: '8GB',
    }),
    index: new RedisIndexCacheStore({
      url: 'redis://localhost:6379/0',
      ttl: 600,
    }),
  },
)
Si ejecutas Mirage dentro de un contenedor, puedes combinarlo con una configuración de Redis en Docker para un stack totalmente autocontenido.
Workspaces portables
Los workspaces son portables. Puedes hacer snapshots, clonarlos y versionarlos.
# Save workspace state
ws.snapshot("my-workspace.tar")

# Load it elsewhere
restored = Workspace.load("my-workspace.tar", id="restored")# CLI equivalent
mirage workspace snapshot my-agent my-agent.tar
mirage workspace load my-agent.tar --id restoredPuedes guardar el entorno de trabajo de un agente y restaurarlo en otra máquina, versionar las configuraciones del workspace junto a tu código, o reproducir ejecuciones del agente restaurando exactamente el mismo estado del sistema de archivos.
Ejemplo real: análisis de logs multiservicio
Aquí tienes un flujo de trabajo concreto que extrae datos de tres servicios para producir un informe:
from mirage import Workspace
from mirage.resource.ram import RAMResource
from mirage.resource.s3 import S3Config, S3Resource
from mirage.resource.slack import SlackConfig, SlackResource
from mirage.resource.github import GitHubConfig, GitHubResource

ws = Workspace({
    "/data":   RAMResource(),
    "/s3":     S3Resource(S3Config(bucket="app-logs")),
    "/slack":  SlackResource(SlackConfig()),
    "/github": GitHubResource(GitHubConfig()),
})

# Find errors in S3 logs
await ws.execute("grep -i 'error' /s3/production/2026-05-*.log > /data/errors.txt")

# Count by frequency
await ws.execute("sort /data/errors.txt | uniq -c | sort -rn > /data/top-errors.txt")

# Check if these were reported in Slack
await ws.execute("grep -f /data/errors.txt /slack/incidents/*.json > /data/slack-matches.txt")

# Cross-reference with GitHub issues
await ws.execute("grep -i 'error' /github/my-app/issues/ > /data/github-issues.txt")

# Combine into a report
await ws.execute("cat /data/top-errors.txt /data/slack-matches.txt /data/github-issues.txt > /data/report.txt")
El agente maneja esto de la misma manera que un desarrollador lo haría en una máquina local — grep, sort, uniq, pipes. La diferencia es que los datos viven en S3, Slack y GitHub, y el agente no necesita saberlo.
Consejos para trabajar con Mirage
- Usa RAMResource como bloc de notas local para resultados intermedios, como
/tmp - Nombra las rutas de montaje con claridad —
/s3,/slack,/githubson más fáciles de razonar para los agentes que/m1,/m2,/m3 - Cambia a caché Redis para producción; la caché RAM por defecto no sobrevive a reinicios ni se comparte entre procesos
- Guarda el estado del workspace antes de tareas largas del agente para poder restaurarlo si algo sale mal
- Combina Mirage con agentes de codificación como OpenCode o Hermes Agent que ya usan interfaces de shell
- Consulta la matriz de recursos antes de construir — no todos los backends soportan todas las operaciones
Solución de problemas
Los comandos devuelven resultados vacíos
Comprueba que tus credenciales están configuradas correctamente. Mirage lee las credenciales de servicio de variables de entorno por defecto. Verifica con:
# Check what's mounted
await ws.execute("ls /")

# Check a specific mount
await ws.execute("ls /s3/")
Si el montaje está vacío pero no debería estarlo, verifica la configuración del bucket/token/credencial para ese recurso específico.
Los pipes fallan entre montajes
La mayoría de los pipes funcionan entre montajes, pero algunos comandos tienen un comportamiento específico del recurso. Si un pipe falla, prueba a dividirlo en pasos separados usando un RAMResource como almacenamiento intermedio:
await ws.execute("cat /s3/data.json > /data/temp.json")
await ws.execute("jq '.items[]' /data/temp.json > /data/filtered.json")
El rendimiento parece lento
Las primeras lecturas siempre llegan a la red. Las lecturas posteriores usan la caché. Si haces I/O intensivo:
- Cambia a caché Redis para compartir caché entre procesos
- Usa
mirage provision(CLI) para precalentar la caché antes de las ejecuciones del agente - Comprueba si tu backend tiene límites de velocidad (especialmente las APIs de Slack y Google)
¿Qué modelo funciona mejor con Mirage?
Cualquier modelo que maneje bien bash sirve. Los modelos entrenados intensamente en código y comandos de shell tienden a rendir mejor. Si buscas opciones asequibles, consulta Los Mejores LLMs Open Source para Codificación o Los Mejores Modelos Baratos para Hermes Agent. También puedes ejecutar Mirage con modelos gratuitos a través de OpenRouter o LiteLLM.
Próximos pasos
Mirage resuelve un problema real en el desarrollo de agentes: conectar agentes a múltiples servicios sin ahogarse en boilerplate de SDK. La abstracción del sistema de archivos es familiar tanto para desarrolladores como para LLM, lo que la convierte en una base práctica para flujos de trabajo de agentes multiservicio.
- Repositorio de Mirage en GitHub para el código fuente e issues
- Documentación de Mirage para la referencia completa de la API y la matriz de recursos
- Discord de Mirage para soporte de la comunidad
- Guía de Configuración de Hermes Agent para combinar Mirage con un agente de IA autoalojado
- Configuración de VPS para Agentes de Codificación IA para preparar un servidor para cargas de trabajo de agentes
- Los Mejores LLMs Open Source para Codificación para modelos asequibles que manejan bien bash
Si estás construyendo agentes que tocan más de un servicio, Mirage merece una mirada seria. El tiempo de configuración de 10 minutos no es palabrería de marketing — una vez que tienes las credenciales de un backend, montarlo es una sola línea de configuración.
Más guías de herramientas de IA